Исследование, защищавшее rsync от Claude, само написано языковой моделью
Анализ, оправдывающий коммиты ИИ в rsync, проводит перестановочные тесты, точный критерий Фишера и взвешенные по серьёзности метрики ошибок — и приходит к выводу «нет значимых различий». Ответ треда: вы сделали этот вывод ровно по двум релизам Claude, а ваш же текст — типичный ИИ-слоп.
Защита коммитов ИИ, написанная так, будто её сгенерировал ИИ
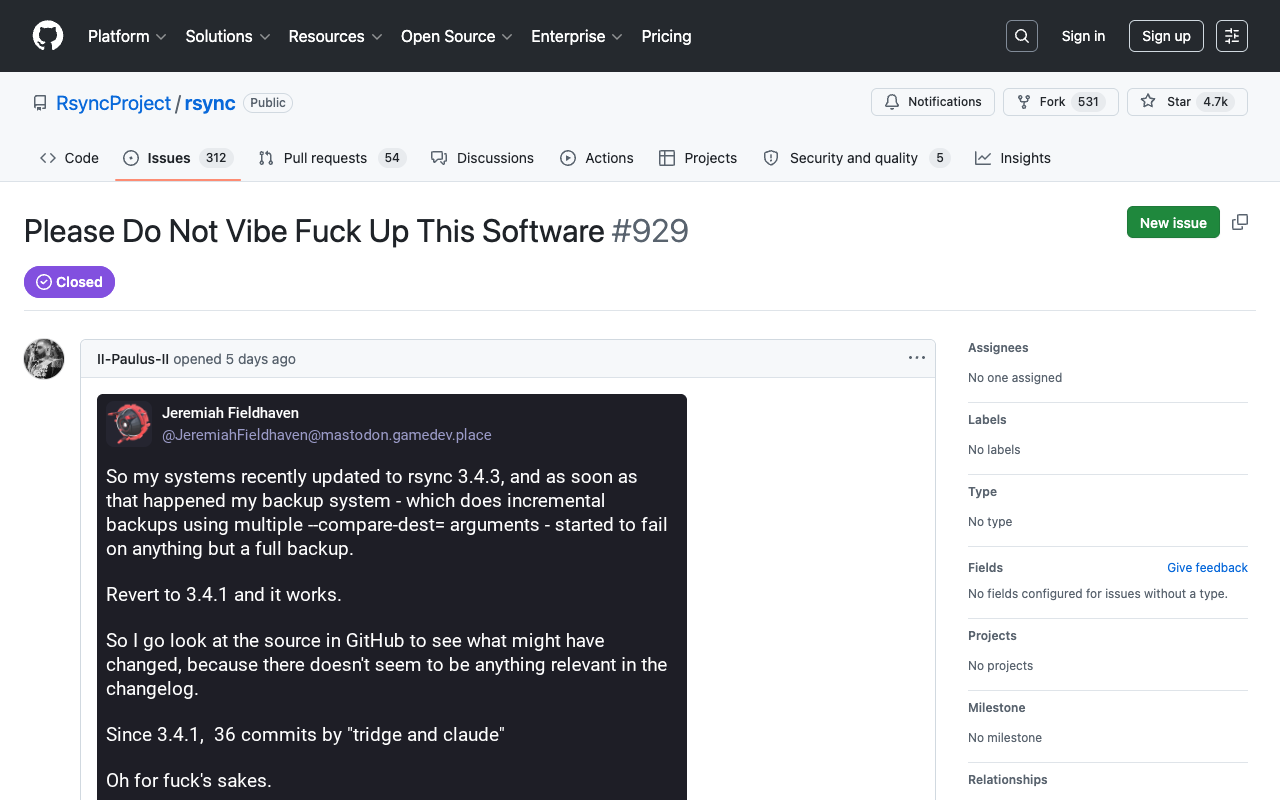
Когда пост в Mastodon обвинил мейнтейнера rsync в том, что тот позволяет коммитам от Claude деградировать проект, появился статистический ответ, призванный урегулировать вопрос данными. Автор по нику logicprog построил взвешенную по серьёзности метрику ошибок, прогнал перестановочные тесты и точный критерий Фишера по всем релизам rsync и пришёл к выводу: возмущение не имеет эмпирических оснований. Пост набрал 355 голосов и 364 комментария — большинство из них посвящено тому, что опровержение страдает той же болезнью, что и объект защиты.
Что на самом деле показывают цифры
Метрика — взвешенные по серьёзности баги на 10 коммитов (sev/10c): каждый из ~2000 баг-репортов получает оценку от 0 до 100 от языковой модели при температуре 0, нормируется и суммируется по релизам. Ключевое сравнение:
| Релиз | Баги | Sev/10c | Коммиты Claude | Перцентиль |
|---|---|---|---|---|
| v3.4.1 | 59 | 39.39 | 0 | 97th |
| v3.4.2 | 0 | 0.00 | 9 | 0th |
| v3.4.3 | 17 | 3.29 | 28 | 77th |
Историческое среднее составляло 2,95 sev/10c; релизы с Claude в среднем дали 1,65. Точный перестановочный тест вернул p ≈ 46% — возьмите два случайных релиза, и почти в половине случаев разброс окажется не лучше. Точный критерий Фишера — 74%. Главное наблюдение автора: v3.4.1, худший релиз в истории rsync, вышел до появления Claude, и «никто не заметил, потому что не было ИИ, на которого можно было свалить вину».
Проблема двух точек данных, которую невозможно было проигнорировать
Самое острое возражение треда — арифметическое. Нельзя делать статистические выводы по двум релизам с участием ИИ, сколько бы тестов поверх них ни накладывать.
«Подождите, как вообще что-либо из этого имеет значение, если коммитов от Claude было всего 2? Статистика давно позади, но разве не нужно хотя бы 30 точек данных, чтобы делать какие-то выводы?» — участник треда, вспомнивший курс статистики
«Если бы вы написали статью, где делаете статистические выводы из целых 2 точек данных, вас бы подняли на смех» — скептик о размере выборки
И ноль в v3.4.2 делает немало тихой работы: релиз с буквально нулём багов — выброс, каких в наборе данных больше нет, — тянет среднее по Claude вниз.
«Почему в v3.4.2 ноль багов… И почему такой выброс… вообще попал в агрегированную статистику и потянул все оценки «баговитости Claude» вниз. Честно говоря, непонятно, как это не стало красным флагом в анализе автора…» — читатель, которому осталось больше вопросов, чем ответов
Другие указали, что атрибуция багов по дате релиза вносит систематическую ошибку: 3.4.1 вышел на день раньше, чем можно было подать баги на 3.4.0, поэтому они накапливаются в более долгоживущем патч-релизе; а свежие релизы просто не успели обрасти репортами, как подробно разобрал один из читателей.
Бывший инженер Meta, нашедший реальный случай
Самый конкретный вклад — не критика статистики, а ревью кода. Макс, по его словам работавший над HHVM в Meta, извлёк конкретный коммит от Claude и его откат:
«Хороший пример того, что ускользает от внимания LLM. Он переводит все аллокации на calloc, как будто это безусловное улучшение. Для больших и рекурсивных аллокаций это становится существенной нагрузкой… если прочитать описание отката хотя бы вполглаза, нетрудно понять, что оно тоже написано языковой моделью.» — бывший инженер Meta, работавший над HHVM
Amluto пошёл дальше и разобрал коммит, где do_foo(args) механически переименовывалось в do_foo_at(args) — _at означает «по файловому дескриптору директории», который так и не указывается, — и функция буквально называлась do_utimensat_at:
«Есть функция do_utimensat_at. Claude заикается?… Если хочешь вычистить весь мусор из C-программы вроде rsync силой LLM — перепиши её на Rust… хотя бы используй язык, который более устойчив к слопу.» — системный программист, изучавший дифф
Мета-ирония — и история травли под ней
Главное обвинение: защита съела собственный аргумент — материал, утверждающий, что LLM не выдают уверенный мусор, сам, по мнению многих читателей, написан LLM и статистически самонадеян.
«Автор использовал LLM для интерпретации данных в этом исследовании и, судя по всему, допустил ту же категорию ошибки — уверенное утверждение ложного, — которую исследование и должно было изучать» — читатель, назвавший мета-иронию своими именами
Автор уточнил в треде, что карточки и цифры подставляются скриптом, а не галлюцинируются моделью — «галлюцинации здесь нерелевантны», — а tptacek, похвалив работу, оставил заметку о стиле письма: используй LLM для критики структуры, но никогда не отправляй ни слова из того, что он предложил.
Самая неприятная часть — настоящая. В посте задокументирована оригинальная драма с мейнтейнером, вылившаяся в открытую травлю: рисунки в стиле My Little Pony с изображением удушения «janitor проекта, заливавшего вайб-кодированные коммиты», и угрозы убийством. Одна поправка прозвучала в треде: мейнтейнер Lobsters pushcx отметил, что brigading так и не достиг Lobsters, сослался на код, предотвращающий это, и попросил исправить текст.
Честный вердикт: не оправдан, но и не осуждён
Отбросьте p-значения — и результат окажется уже, чем хочет любая из сторон. Данные не показывают, что Claude сломал rsync, — но двух релизов и метрики, которая ставит знак равенства между однострочной опечаткой и патчем CVE, недостаточно, чтобы показать обратное. Самое долговечное предсказание в треде принадлежит читателю, который увидел дальше математики: давите на мейнтейнеров достаточно сильно — и вы не остановите коммиты ИИ, вы просто научите всех перестать их раскрывать.
Получайте такие разборы каждый день
Главные истории Hacker News — на email, в Telegram или RSS.
Это последняя новость выпуска 6 июня 2026.
Перейти в архив выпусков