Xiaomi MiMo: 1000 токенов в секунду на триллионной модели — восемь обычных GPU
До сих пор четырёхзначная скорость токенов означала кремний класса Cerebras. Xiaomi заявляет, что преодолела отметку 1000 токенов/с на модели с триллионом параметров на одном стандартном сервере с 8 GPU — за утроение цены и десятикратный прирост производительности.
Секрет — квантизация FP4 для MoE-экспертов плюс системный слой с персистентными ядрами TiLeRT, дающий пиковые ~1200 токенов/с. Тред разделился: настоящий прорыв или новые мегапиксели в маркетинге ИИ.
Сильнее всего впечатлило не число токенов, а железо: никакого Cerebras — один сервер с 8 GPU. Подвох виден в собственной таблице принятия токенов Xiaomi: метод слабеет именно там, где разговор становится непредсказуемым.
Триллионная модель, 1000 токенов в секунду — на восьми обычных GPU
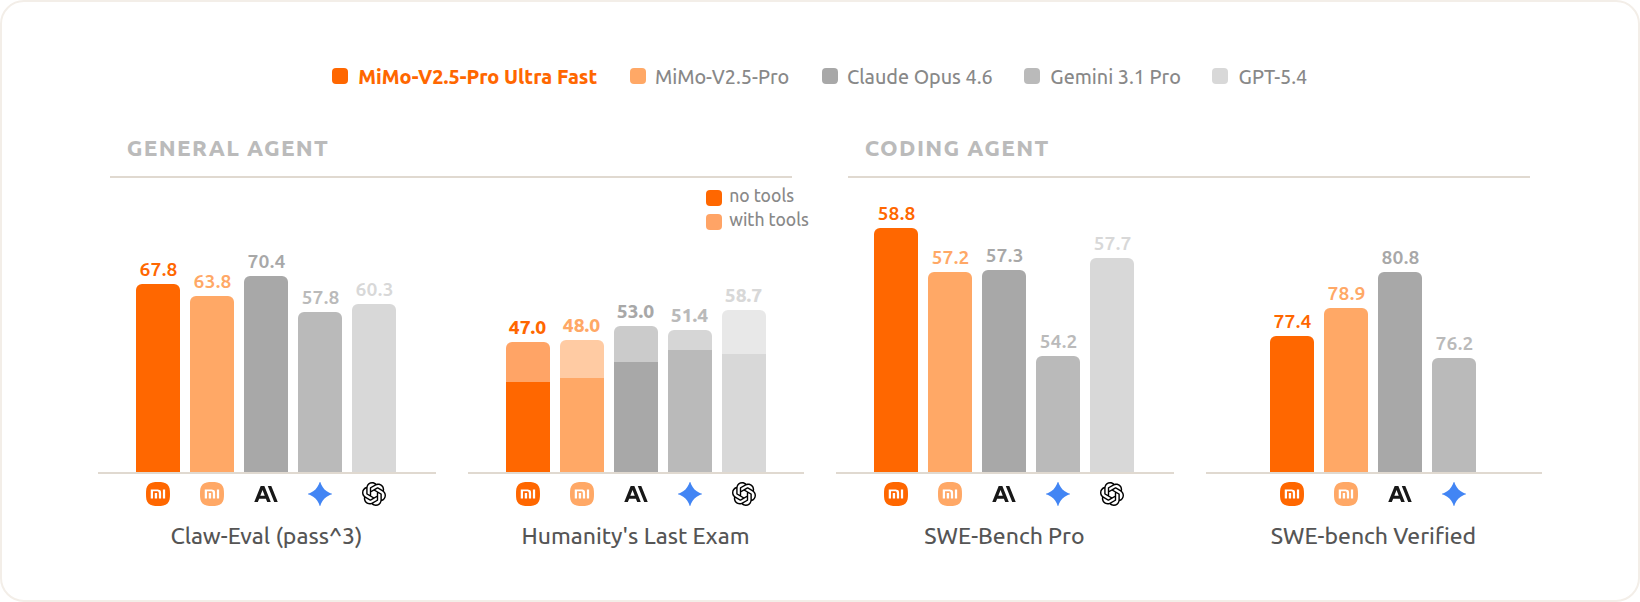
Команда MiMo от Xiaomi опубликовала релиз с заявкой на первенство: скорость декодирования свыше 1000 токенов/с на модели с 1 триллионом параметров, с пиками около 1200 токенов/с — на одном стандартном сервере с 8 GPU, без экзотического железа на пластинах. Пост набрал 525 голосов и 380 комментариев, и центр тяжести треда сосредоточился на вопросе: «1000 токенов/с» — это настоящий системный прорыв или новые мегапиксели в маркетинге ИИ.
Что под капотом
MiMo-v2.5-Pro-UltraSpeed — та же триллионная модель, что и базовый MiMo-v2.5-Pro, перепроектированная под минимальную задержку. Рецепт по релизу:
- Архитектура: разреженная смесь экспертов (MoE) (~42B активных параметров) со скользящим вниманием на черновой модели
- Квантизация: FP4 применяется избирательно к MoE-экспертам; остальные модули сохраняют исходную точность — заявлена «практически нулевая потеря качества»
- Спекулятивное декодирование: блочный метод параллельного маскированного предсказания (DFlash) с сохранением качества через выборку с отклонением
- Системный слой: TiLeRT — персистентное CUDA-ядро, удерживающее вычислительный конвейер в памяти GPU вместо перезапуска отдельных операторов, плюс специализация варп-потоков
Заявленный компромисс от Xiaomi: 3× цена, 10× опыт по сравнению со стандартной моделью. Тип GPU в релизе не указан — тред предполагает Blackwell с нативной поддержкой FP4.
Единственная количественная таблица в посте — это длина принятия (сколько токенов спекулятивный декодер принимает за шаг: чем больше, тем быстрее), а не бенчмарк качества:
| Сценарий | Длина принятия |
|---|---|
| Кодирование | 6,30 |
| Математика / Рассуждение | 5,56 |
| Агент | 4,29 |
| Общий диалог | ниже (высокая неопределённость) |
Два демо-GIF в релизе — генерация игры «Змейка» с нуля и сессия кодирования на macOS — убедили многих в треде, что скорость реальна.
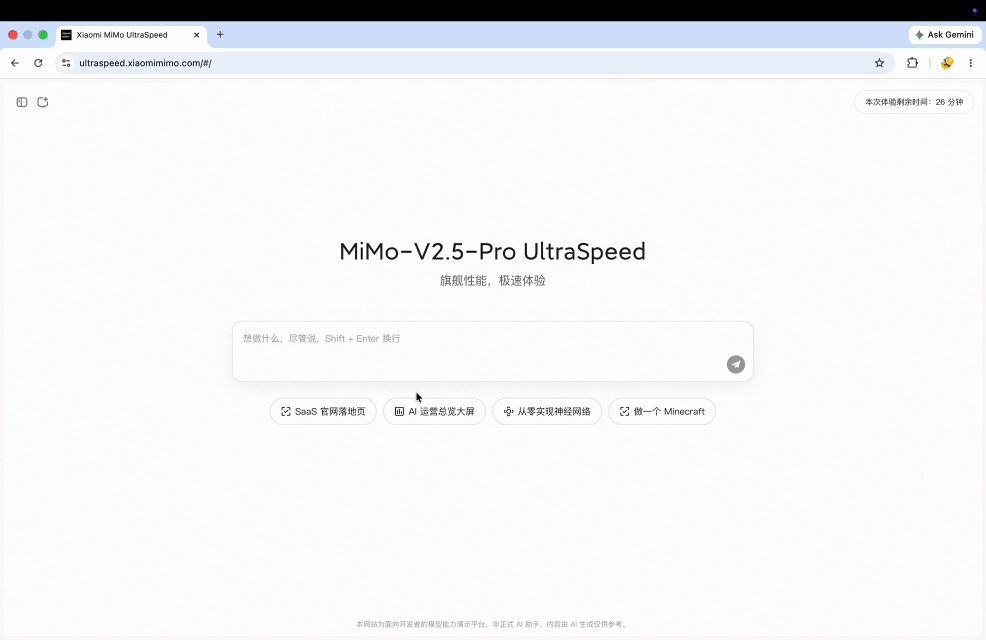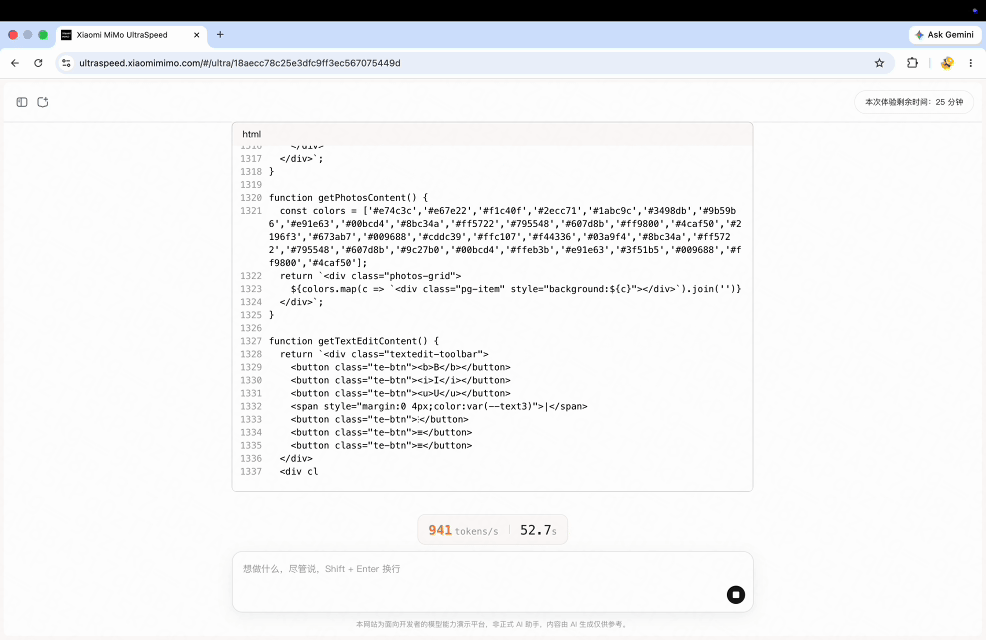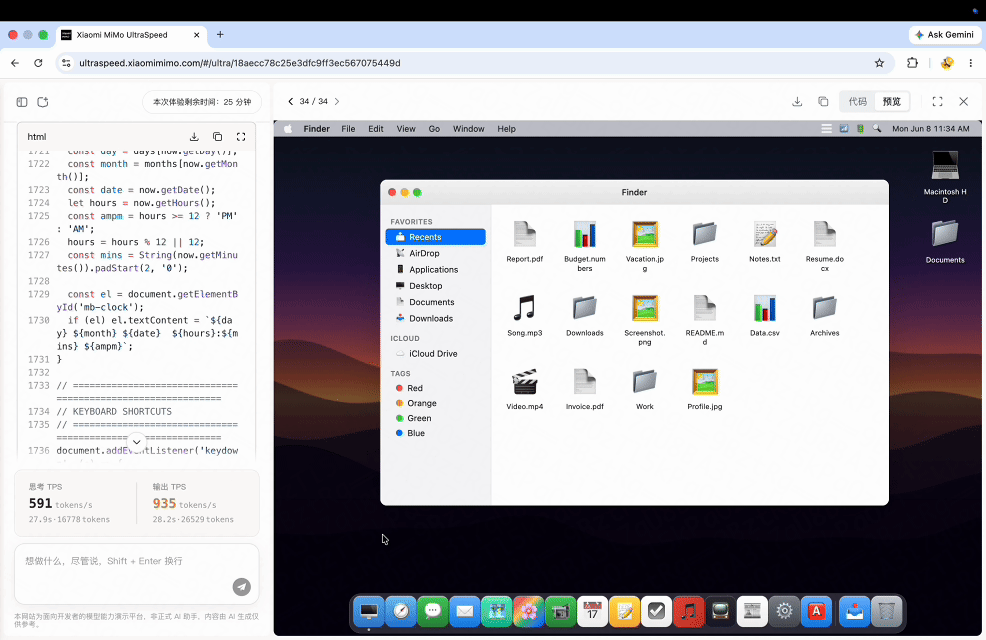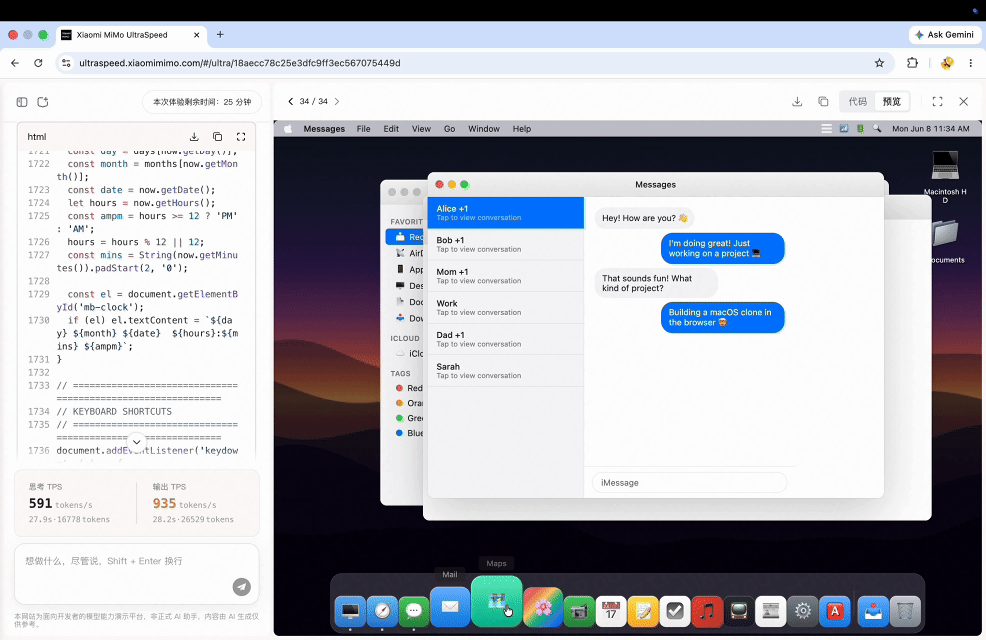
Тред читает спецификацию и находит звёздочку
Самая цитируемая техническая поправка появилась быстро. Строчку «42B активных параметров + скользящее внимание» отметили как компромисс, но сразу же уточнили:
«Скользящее внимание — для черновой модели, не для основной. 42B активных параметров — потому что это разреженный MoE, стандартная техника для крупных моделей, чтобы не упираться в пропускную способность памяти.» — комментатор, уточняющий архитектурное чтение
Читатель, который поначалу спросил «Как?», обновил мнение после прочтения поста: это «очень эффективный MTP-алгоритм», но он усомнился, что качество падает «совсем чуть-чуть», как заявлено, — «сильно квантизованные модели очень часто дают худший результат» в общем использовании, именно там, где таблица длины принятия показывает ослабление метода. Другой комментатор нашёл корни системной работы в открытом коде:
«Они используют TileRT — персистентное CUDA-ядро, тайловая обработка с перекрывающимися чтением/записью, модель спроектирована с учётом конкретных ограничений.» — комментатор, указывающий на репозиторий tile-ai/TileRT
Почему «один стандартный сервер» важнее числа токенов
Деталь, произведшая наибольшее впечатление, — доступность железа. До сих пор четырёхзначные скорости означали кремний класса Cerebras:
«В статье сказано, что до сих пор требовалось специальное и очень дорогое железо типа Cerebras для достижения таких скоростей… новизна в том, что они получили свыше 1000 токенов/с для модели с >1T параметров на обычном железе, то есть на одном сервере с 8 GPU.» — комментатор о том, почему обычное железо и есть главная история
Это создало конкурентный подсюжет. Один комментатор отметил, что Cerebras тестирует Kimi K2.6 на 3000 токенов/с (только по приглашениям), указывая: интересный ход — быстрые модели под Nvidia, сокращающие разрыв с платформами на пластинах. У скептиков была готовая реплика:
«Токены в секунду — это мегапиксели в маркетинге ИИ!» — комментатор о хайпе вокруг пропускной способности
Возражение признало правоту лишь на крайних значениях:
«Это реальное и значимое число для большей части диапазона… Между 10 и 100 токенами/с — ощутимая разница в удобстве работы, и, думаю, аналогично для перехода 100→1000.» — комментатор, защищающий метрику ниже маркетингового потолка
Главный сигнал: пропускная способность становится полем битвы
Скорость превращается в самостоятельную конкурентную ось. При MiMo на ~1000 токенов/с на обычных GPU и Kimi на 3000 токенов/с на Cerebras консенсус треда таков: следующая фаза гонки LLM — это пропускная способность, а не только интеллект; достаточно быстрая модель удерживает разработчика в потоке или встраивается в системы, обязанные реагировать за миллисекунды. Подвох скрыт в таблице длины принятия: метод отточен для кодирования, математики и агентных задач и деградирует именно там, где диалог становится непредсказуемым. Xiaomi предлагает лишь ограниченный пробный доступ (9–23 июня, только по заявке) — тред прочитал это прямолинейно: у них, возможно, просто не хватает серверных стоек.
Получайте такие разборы каждый день
Главные истории Hacker News — на email, в Telegram или RSS.
Эд Зитрон: ИИ требует триллионов в год, и HN не может опровергнуть его арифметику
После того как OpenAI и Anthropic перешли на поштучную тарификацию токенов, Uber сжёг годовой AI-бюджет за один квартал и ограничил инженеров суммой в $1500 в месяц. Эд Зитрон утверждает, что это пузырь, ставший наконец видимым — и даже его критики не спорят с цифрами.