ИИ-агент Bayer для исследования лекарств — и оценка 3,1/5,0, которую статья опустила
Тридцать абзацев расписывают мультиагентную архитектуру, оркеструющую поиск, рефлексию и написание. Два абзаца — про оценку качества. Жёсткая цифра, насколько хорошо система отвечает на запросы пользователей, всплывает только в связанной статье, которую комментатор взял и прочитал.
PRINCE — ассистент Bayer для доклинических исследований, выросший из поиска по ключевым словам в разговорного агента. Его надёжность держится на инженерии контекста (каждый агент видит только нужное ему) и инженерии обвязки (сохранённое состояние, повторы, резервные провайдеры).
Статья называет RAGAS и метрики достоверности, но не приводит собственных цифр ни по точности, ни по задержке.
Читатель добыл недостающую из первоисточника: общая способность — 3,1/5,0, и это для инструмента медицинских исследований.
Строка поиска, ставшая мультиагентной системой
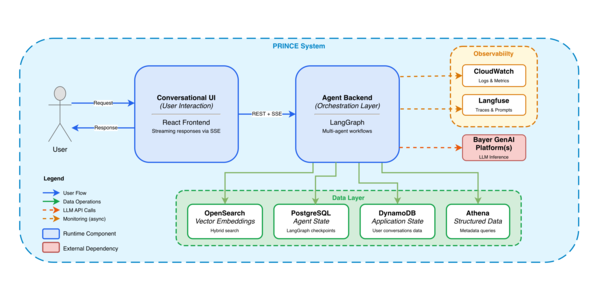
На martinfowler.com Саранг Кулкарни, ведущий консультант Thoughtworks, разбирает PRINCE — ассистента Bayer для доклинических исследований, который вырос из поиска по ключевым словам в разговорную агентную систему.
Как PRINCE отвечает на исследовательский вопрос
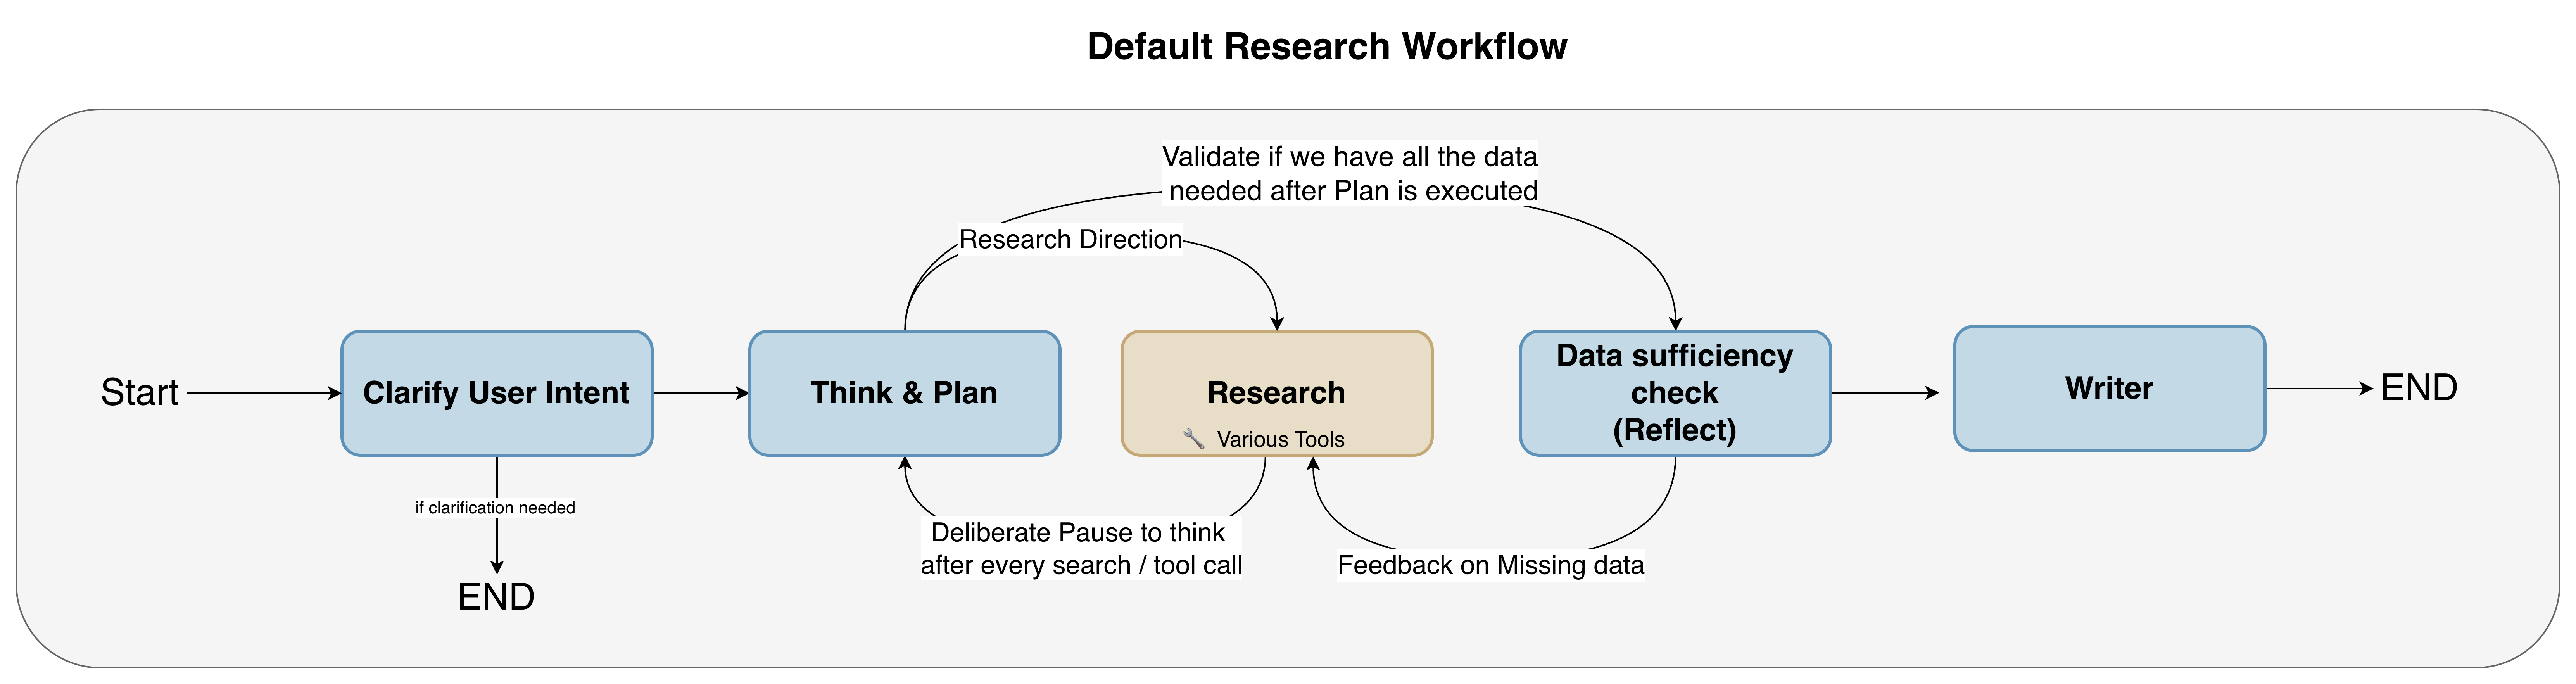
Конвейер — это цепочка специалистов, оркеструемая LangGraph. Запрос идёт по маршруту «Уточнить намерение» → «Подумать и спланировать» → Исследователь, который запускает гибридный ретривер, сочетая RAG по PDF в OpenSearch с Text-to-SQL по структурированным метаданным в Athena. Затем агент Рефлексии проверяет, достаточно ли извлечённых данных, и только после этого агент-Писатель синтезирует ответ со ссылками.
Надёжность Кулкарни ставит на два столпа. Инженерия контекста означает, что каждый агент видит только нужное, сохраняя промпты узкими. Инженерия обвязки — это операционные леса: состояние в PostgreSQL через чекпойнтер LangGraph, автоматические повторы, резервные LLM-провайдеры и мягкое восстановление, когда шаг падает. Статья называет фреймворки оценки (RAGAS, faithfulness, answer-relevancy), но не приводит собственных цифр ни по точности, ни по задержке.
Тред хочет абляцию — и метрику
Первое возражение: замысловатую декомпозицию ни разу не оправдывают сравнением с более простой базой. Один программист сказал прямо: «агент — это просто системный промпт и контракты на вывод, а эти богатые архитектуры, похоже, важничают сверх своей реальной ценности. Всё это слегка отдаёт вайбкодингом».
«агент — это просто системный промпт и контракты на вывод, а эти богатые архитектуры, похоже, важничают сверх своей реальной ценности. Всё это слегка отдаёт вайбкодингом.» — James, программист
Затем читатель залез в связанную статью во Frontiers и вытащил цифру, которую пост так и не печатает:
«общая способность чат-бота полностью удовлетворять потребности пользователей получила более низкую среднюю оценку (3.1/5.0)… Это система для научных исследований лекарств, и посредственность с галлюцинациями будут убивать людей.» — комментатор, ссылающийся на цифру из самого первоисточника
Инженер, выпускавший такие системы, доказывал, что архитектура занимает лёгкий 1%, а данные — остальные 99:
«Я предлагал кастомного корпоративного агента… думал, время разделится 50/50 между данными и настройкой агента, но вышло скорее 99/1.» — инженер, построивший кастомного корпоративного агента
И пропорции самого текста попали под огонь:
«Раздел про оценку на два абзаца после 30 абзацев, объясняющих самую заурядную rag-систему, о какой вы только слышали.» — читатель, прикидывающий, насколько доверять тексту
Архитектуру видно; результаты — нет
Разрыв и есть сюжет. Схемой агентов легко восхищаться и трудно её опровергнуть, а 3,1/5,0 за удовлетворение потребностей пользователей это тот факт, который решает, стоит ли всему этому вообще попадать в исследования лекарств. Тред всё кружит вокруг одной причины, почему статья кажется жидкой: она описывает машину в исчерпывающих деталях, а результаты в двух абзацах, тогда как для медицинского инструмента результаты и есть единственное, что важно.
Получайте такие разборы каждый день
Главные истории Hacker News — на email, в Telegram или RSS.
Мозг не был рассчитан на столько плохих новостей до обеда
Война в одном регионе, финансовый шок в другом, климатическая катастрофа в третьем — и всё это до полудня. Контур оценки угроз, когда-то сохранявший вам жизнь, теперь срабатывает на события, которых вы никогда не коснётесь.