Drop-in замена токенайзера обещает скорость в 1000 раз выше HuggingFace на тех же чипах
GigaToken токенизирует датасет в 11,9 ГБ со скоростью 24,5 гигабайта в секунду на 144-ядерном сервере — примерно в 989 раз быстрее токенайзера HuggingFace на идентичном железе. Один читатель задал очевидный вопрос: чья вообще нагрузка упирается в токенизацию?
GigaToken — опенсорсная drop-in замена библиотеки токенайзеров HuggingFace, заявляющая до ~1268x прироста пропускной способности на том же бенчмарке — SIMD-оптимизированная предтокенизация по регулярным выражениям плюс агрессивное кэширование, а не новый алгоритм.
Протестировано на трёх семействах чипов — серверный AMD EPYC, Apple M4 Max и десктопный Ryzen — ускорение держится везде: от 106x на самом слабом чипе до 1268x на кремнии Apple.
Самый заплюсованный ответ мягко остудил хайп: токенизация обычно занимает менее 0,1% общего времени инференса — так кому это вообще нужно?
Цифры прежде оговорки
GigaToken позиционирует себя как «~в 1000 раз быстрее токенайзеров HuggingFace, drop-in замена»: токенизация здесь — шаг, превращающий сырой текст в последовательности целых чисел, которые реально потребляет языковая модель, процесс, через который проходит каждый прогон обучения и каждый вызов инференса. Цифры бенчмарка, полученные на датасете в 11,9 ГБ с токенайзером GPT-2, подтверждают заголовок: 24,53 ГБ/с на 144-ядерном сервере AMD EPYC (примерно в 989 раз быстрее HuggingFace на том же железе), 8,79 ГБ/с на Apple M4 Max (около 1268x) и 6,27 ГБ/с на 16-ядерном десктопе Ryzen 9800X3D (около 106x): ускорение растёт вместе с числом ядер, но держится даже на потребительском железе.
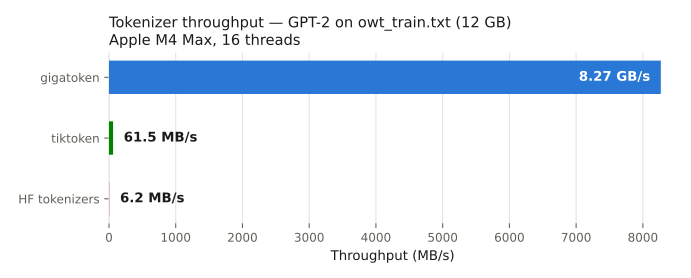
Это не новый алгоритм токенизации: это SIMD-векторизация, применённая к шагу предтокенизации на регулярных выражениях, который библиотеки общего назначения обычно отдают на откуп универсальному движку regex, в сочетании с агрессивным кэшированием отображений предтокенов, чтобы пропускать повторные поиски, и осознанной минимизацией переходов между Python и нативным кодом и издержек на коммуникацию между потоками. Проект поддерживает большинство распространённых токенайзеров на основе BPE (Llama, Qwen, GPT-2, Phi, DeepSeek, GLM), хотя заметно пропускает WordPiece целиком и даёт более скромный прирост для токенайзеров на базе SentencePiece, поскольку эти архитектуры не так чисто ложатся на тот же подход оптимизации.
«Токенизация обычно занимает меньше 0,1% времени инференса»
Самый заплюсованный ответ треда, от комментатора с максимальным весом кармы, добавил к заголовочной цифре по-настоящему полезную оговорку: «Это круто, но токенизация обычно <0,1% общего времени инференса». Для одного завершения чата через развёрнутую модель издержки токенизации практически незаметны: упирающийся в GPU прямой проход доминирует на порядки, и срезание миллисекунд с токенизации никак не сдвинет задержку ответа чат-бота.
Но тот же ответ сразу сузил реальную аудиторию: «Наверняка есть куча приложений, которым нужна просто токенизация, и для них это отлично подойдёт». Это и есть настоящий кейс использования, не обслуживание инференса, а стадия пайплайна обучающих данных, где миллиарды токенов обрабатываются один раз, офлайн, до начала обучения, и где токенизация реально может доминировать в затраченном времени на больших корпусах. Ускорение в 1000 раз на предобработке датасета в 11,9 ГБ — это разница между шагом пайплайна, измеряемым минутами, и шагом, измеряемым сутками, особенно для небольших лабораторий или независимых исследователей без неограниченных вычислительных ресурсов на подготовку данных.
Второй комментатор прощупал специфичность оптимизации: «Вы случайно не переоптимизировали под конкретный CPU и токенайзер?» Собственный ответ проекта, процитированный в том же ответе, оказался обратным: «Нет, я переоптимизировал под каждую комбинацию! Результаты очень стабильны по всем сочетаниям CPU и токенайзера» — заявление, которое отчасти подтверждает разброс бенчмарка по трём семействам чипов, хотя независимая проверка по более полной матрице типов токенайзеров пока остаётся делом будущего за пределами собственных цифр проекта.
Получайте такие разборы каждый день
Главные истории Hacker News — на email, в Telegram или RSS.
Гайд по Postgres советовал стартапам сперва нормализовать схему. HN сказал: сначала — мониторинг
Гид по выживанию в Postgres от Hatchet ведёт стартапы от дизайна схемы через пулинг соединений до партиционирования. Самая острая критика в треде пришла от человека, пережившего сбой, который гайд обходит стороной: никто не замечает приближения transaction ID wraparound, пока пейджер не сработает на Рождество.