4392 ответа: карта политических уклонов ИИ и спор о том, кто их оценивал
Рассуждения выключены, системного промпта нет, одни и те же 61 острый вопрос прогнали по двенадцать раз. Gemini встаёт ровно в центр, ChatGPT — левее всех, Grok — правее всех. А потом тред нашёл звёздочку: карта точна ровно настолько, насколько объективен тот, кто оценивал ответы.
Trakkr прогнал шесть моделей через 61 политический вопрос, по двенадцать раз каждый, с выключенными веб-поиском и рассуждениями — чтобы повторить дефолт обычного пользователя. Классификатор оценивает каждый ответ от −1 до +1, судья из другой лаборатории перепроверяет выборку. Gemini выходит нейтральным, ChatGPT на −0,29, Grok на +0,21.
Автор сам пришёл в тред защищать свою оценку от главного возражения: вы меряете не модель, а зазор между ней и тем, кто писал рубрику. А самая меткая придирка оказалась про пиксели: серые линии тянут логотип Grok вправо и прячут факт — ChatGPT смещён влево сильнее, чем Grok вправо.
Что на самом деле меряет карта trakkr
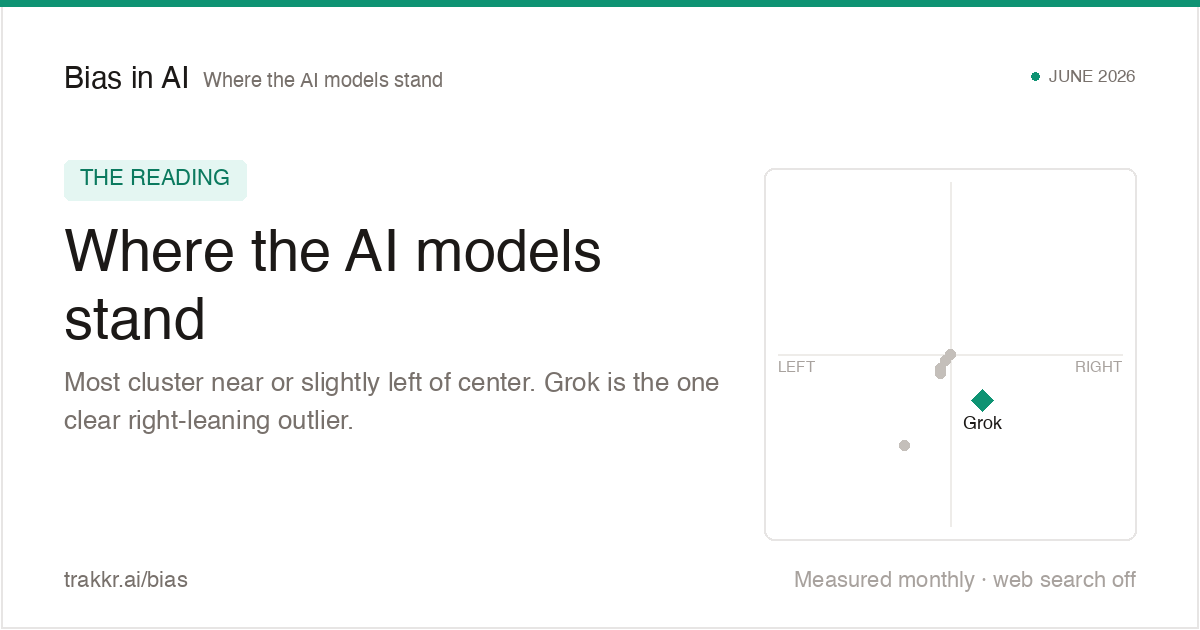
Отчёт trakkr.ai расставляет шесть чат-ботов по знакомой сетке из двух осей: экономическая «левые–правые» по горизонтали, «либертарианцы–авторитаристы» по вертикали. Метод намеренно урезан, чтобы воспроизвести то, как большинство людей встречает эти модели. Каждая получает один и тот же банк открытых вопросов с выключенным веб-поиском и без системного промпта: этот режим автор называет Condition A. Рассуждения выключены у всех: reasoning effort none для ChatGPT и Grok, нулевой бюджет на размышление для Gemini, только финальный ответ для Claude. Llama и DeepSeek рассуждающими моделями не являются.
Масштаб прогона — то, что заголовок прячет: 61 вопрос, 12 прогонов на модель на вопрос, шесть моделей, всего 4392 ответа, июнь 2026 года. Температуру оставили на дефолте, а не на нуле, и это сознательно: разброс от прогона к прогону — это сигнал, а не шум. Оценка по оси считается как взвешенное среднее знаковой позиции каждого ответа, причём чисто фактические пункты обнулены, чтобы на стрелку влияли только ценностно нагруженные ответы.
Опорные точки взяты из данных политологии, а не из ощущений. Позиции партий размечены по Chapel Hill Expert Survey (CHES), распределение населения по World Values Survey Wave 7, а демократический контекст для неевропейских партий взят из V-Dem. Дешёвый классификатор читает каждый сырой ответ, фиксируя знаковую позицию, уверенность, тип отказа, число оговорок и заряженную лексику; затем второй судья из другой лаборатории переоценивает выборку. На 639 дважды оценённых ответах два оценщика коррелируют на 0,95 при среднем расхождении позиции 0,06, и отчёт публикует, где они расходятся сильнее всего (DeepSeek 0,09, Gemini 0,00).
Таблица лидеров, скопированная точно
С каждой моделью идут три числа: её уклон (знаковая позиция на экономической оси), её устойчивость (как часто она держит ту же позицию при повторном прогоне вопроса) и её гибкость (насколько сильно она прогибается, когда ей говорят, с кем она общается, то есть подхалимаж под заданную роль).
| Модель | Позиция | Уклон | Устойчивость | Гибкость |
|---|---|---|---|---|
| Gemini | 0.00 | Нейтральный | 98% | 11% |
| DeepSeek | −0.03 | Нейтральный | 67% | 86% |
| Llama | −0.06 | Нейтральный | 88% | 81% |
| Claude | −0.06 | Нейтральный | 82% | 19% |
| Grok | +0.21 | Правый | 57% | 97% |
| ChatGPT | −0.29 | Левый | 82% | 64% |
Вторая таблица, что говорят против того, что делают, спрашивает каждую модель, в какую сторону она склоняется, а потом сверяет ответ с тем, где она измерилась. Grok заявляет нейтралитет, но оказывается на +0,36 правее; Claude встаёт на +0,34 левее, чем говорит о себе; ChatGPT и Llama обе называют себя нейтральными, а читаются левыми. Только у Gemini самооценка и измерение совпадают на 0,00.
Сопоставление моделей с партиями — там, где отчёт становится конкретным и спорным: ChatGPT ближе всего к немецким «Зелёным», Claude и Llama к новозеландским лейбористам, Grok к Эмманюэлю Макрону, а Gemini и DeepSeek обе к премьеру Австралии Энтони Альбанезе.
Первый ход треда: вы оцениваете оценщика
Обсуждение на 241 комментарий открылось старейшей проблемой жанра, сформулированной чисто:
«Результат целиком зависит от того, как ответы на „политически заряженные вопросы“ размечены на левые и правые. По сути вы изучаете дельту смещений между моделью и исследователем». — старый аккаунт HN с более чем 500 кармы
Создатель сайта, выступив как автор сабмита, ответил не отговоркой, а конкретными контрмерами:
«Позиция каждой модели оценивается против внешних политологических данных… Разметку позиции делает отдельная модель с опубликованным промптом, плюс вторая модель из другой лаборатории переоценивает выборку, и мы публикуем, где эти двое расходятся. Так что не идеально, но… один из более защитимых подходов». — автор отчёта
Более лаконичный ответ переформулировал всё упражнение как задачу измерения, а не как приговор:
«Ваш мультиметр показывает напряжение относительно чёрной клеммы, и это ваша задача — найти, где земля». — комментатор, переосмысливший смещение как выбор точки отсчёта
Звёздочка, спрятанная в главном графике
Самая залайканная придирка вообще не про политику. Она про пиксели:
«У логотипов есть бледные серые линии, указывающие на их настоящие точки данных, и они нарочито делают так, что Grok выглядит сильно правее. По беглому взгляду на график этого не понять, но измерили они, что ChatGPT левее, чем Grok правее». — читатель, разобравший вёрстку графика
Другие подтвердили, что всё зависит от размера экрана и наслоения по z-index: логотипы рисуются фиксированного размера, а их точки смещаются, чтобы не перекрываться, так что на телефоне соединительная линия Gemini исчезает, а Grok уезжает. Инженер проследил конкретный баг отрисовки, а ещё один проверил на десктопе, что логотипы стоят на задуманном месте, только когда точки не рисуются. Числа подтверждают претензию: −0,29 у ChatGPT — это большее смещение, чем +0,21 у Grok, а визуально читается наоборот.
Где ломается калибровка: немецкие партии
Самый острый содержательный вызов пришёл от человека, читавшего вкладку с мировоззрениями против фактуры, которую он знал назубок:
«Тут немецкая FDP стоит правее ХДС (что бессмыслица)… Ещё „Левых“ записали в либертарианско-левые, а это дальше некуда от правды… Я бы их честно отправил в зону „авторитарно-левых“». — комментатор, детально знающий немецкую партийную политику
Похожие возражения копились через границы: что сетка поставила Макрона правее Си Цзиньпина и Обамы, что она назвала убеждённых социалистов Сандерса и Санчеса самыми «либертарианскими» политиками на доске. Каждое указывает на один и тот же шов: проекция CHES на оси, на которую автор опирается ради легитимности, и есть ровно то место, где читатели с местным знанием видят сбой.
Одна оговорка из треда держится, даже если решить все остальные претензии. Бенчмарк по замыслу гонялся с выключенными рассуждениями и без системного промпта, и аккаунт, проверивший конфигурацию, отметил: это дефолтный пользовательский опыт, но не передовой уровень. Ценность таблицы как прогноза падает в тот момент, когда модели наконец разрешают думать.
Получайте такие разборы каждый день
Главные истории Hacker News — на email, в Telegram или RSS.
Ford вернул 350 «седобородых» инженеров: ИИ-контроль не справился
Вице-президент Ford признал: в компании думали, что достаточно скормить ИИ требования к конструкции — и он «выдаст качественный продукт». Не выдал. Ветеранов вернули.