Тег

ChatGPT

15 материалов

ChatGPT отправляет заблокированных пользователей в 404 Media и пишет им письма (404media.co)

404 Media говорит, что её завалили письмами, написанными ИИ, от людей с обычными техническими проблемами. Когда редакция стала спрашивать, как отправители её нашли, каждый из спрошенных отвечал, что чат-бот посоветовал написать именно сюда.

ChatGPT, которого спросили, как вернуть заблокированный аккаунт Instagram, решил, что писать Meta, скорее всего, бесполезно.
🌍Other ★ 219 · 💬 82 · вчера · #ИИ#соцсети#404 Media#ChatGPT#Instagram+2

Не просто заголовок — разбор дискуссии

Главные треды HN: факты из обсуждений, разные стороны, голоса инсайдеров. Email, Telegram или RSS.

Сеть из 50 000 поддельных страниц со статистикой за $50 уже цитируют ChatGPT и катарский банк (peec.ai)

Метехан Есилюрт из Peec AI на GPT-4.1 создал около 50 000 страниц с выдуманной статистикой и 15 000 листиклов. Google понизил сайт после двух обновлений, но ChatGPT продолжал его индексировать: за 30 дней было более 600 000 запросов ботов.

Выдуманные цифры попали в научную статью и инвестиционный обзор крупнейшей финансовой группы Катара.

🚀Tech ★ 323 · 💬 188 · 7 дня назад · #ИИ#веб#ChatGPT#GPT-4.1#Peec AI+1

Теренс Тао выложил переписку с ChatGPT о математической гипотезе. Тред попытался вычислить в ней его самого (chatgpt.com)

Теренс Тао опубликовал сырую переписку с ChatGPT о контрпримере к столетней гипотезе Якобиана — не пересказ математики, а настоящий диалог, сформулированный так, как говорит эксперт, идущий прямо к сути.

Одна строка показалась читателям безошибочно узнаваемой: «Я включил Pro. Продолжишь искать геометрическое объяснение чуда X_3 ~ A3, избегая координат и других немотивированных конструкций?»

Кто-то попробовал трюк, который рано или поздно пробуют все: попросить ChatGPT угадать собеседника по той же переписке. Без подсказок модель предполагает «математик-исследователь или автор статьи».

🌍Other ★ 759 · 💬 452 · 23 июля · #ИИ#наука#ChatGPT#OpenAI#Terence Tao

Альтман называл рекламу «крайней мерой». Теперь она в ChatGPT (ads.openai.com)

Только что запущенная страница обещает рекламу, «чётко помеченную» и «отделённую от ответов», — сначала лишь в семи странах, это около 8% населения мира, и без единого платящего подписчика.

Оговорка спрятана в собственных правилах таргетинга OpenAI: чувствительные переписки остаются без рекламы, а вот память о них — нет. Она всё равно может влиять на то, какая реклама всплывёт в совсем другом чате на следующее утро.

Доказательство блогера, что AI не понимает контекст, рассыпалось при первой проверке (rachelbythebay.com)

URL её блога помечены датой, и фантомные обращения совпадают с этим форматом слишком точно для случайности: модель придумывает пост, даёт читателю ссылку — и ссылка ведёт в никуда. Рэйчел называет это «эффектом амнезии Гелл-Манна» Майкла Крайтона: ловишь источник на уверенных ошибках в теме, которую знаешь, а потом доверяешь ему во всём остальном.

Известный на HN security-инженер отмахнулся от её аргумента как от пересказа спора двухлетней давности. Другая блогерша сказала, что то же самое происходит и на её сайте — под её именем гуляет то, чего она никогда не писала.

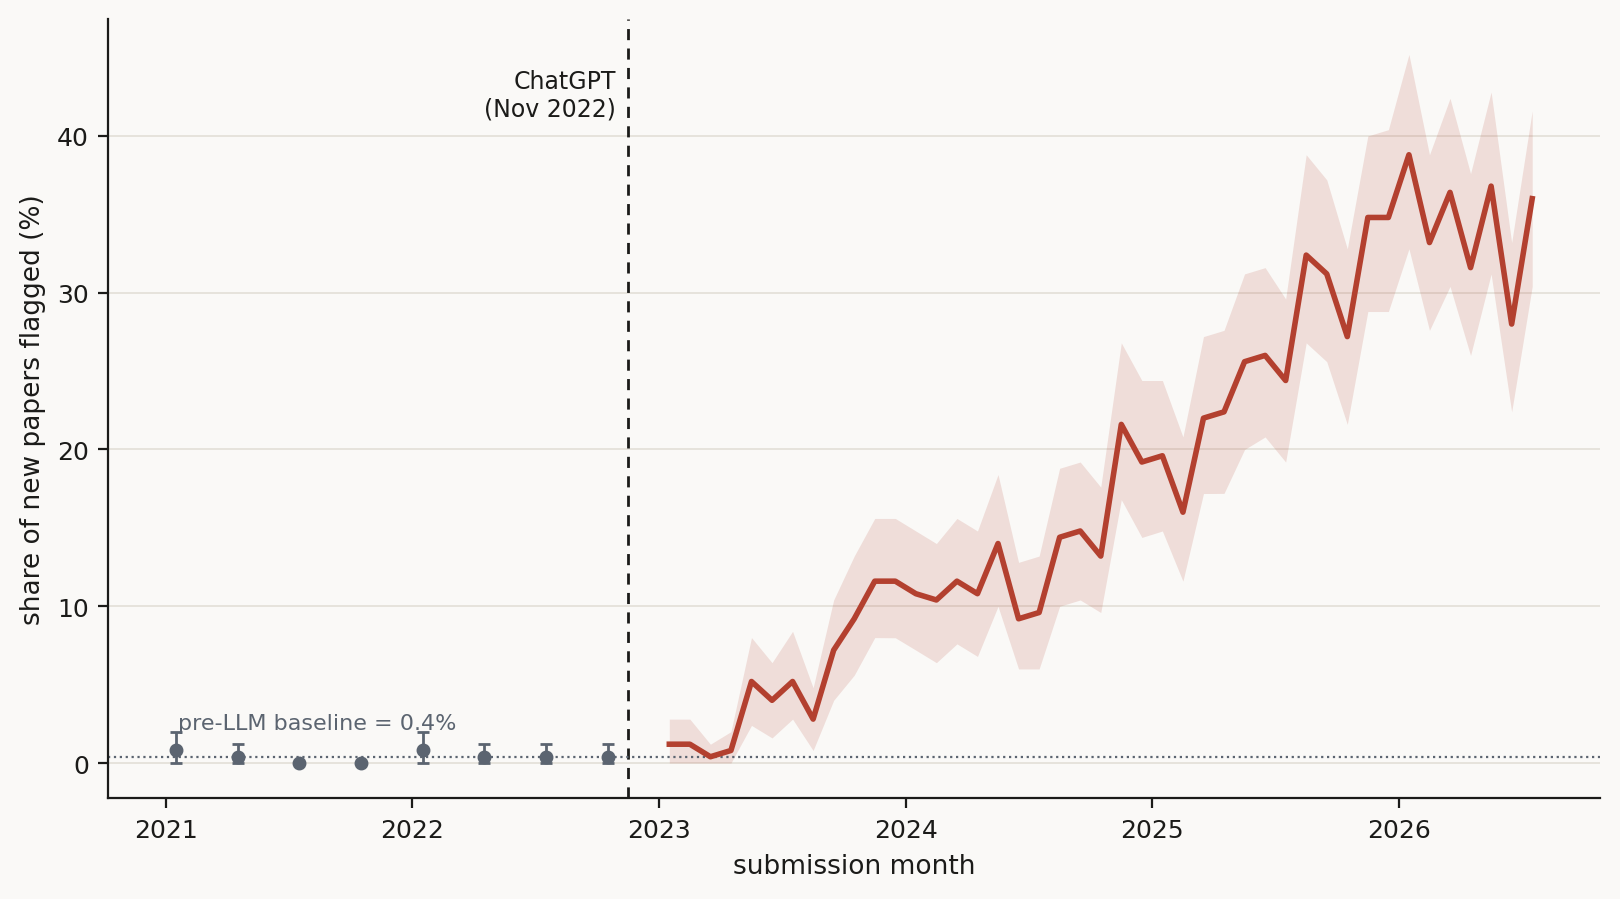
Детектор ИИ-текста пометил 65% статей по CS, а потом и свой же пост (unslop.run)

Детектор пометил статью конференции 2015 года как 74% машинного текста, а диссертацию 2012 года как 40%, хотя обе написаны за годы до появления больших языковых моделей: так рассказал комментатор, прогнавший через инструмент собственные старые работы.

Автор инструмента признал в треде, что не может честно собрать контрольную группу человеческих текстов после 2023 года: любой доступный способ опирается на те же детекторы, которые он пытается обойти.

🚀Tech ★ 194 · 💬 143 · 21 июля · #ИИ#наука#arXiv#ChatGPT#Pangram

Страница про «смещение планки» скептиками сама написана ИИ — и врёт о своих цитатах (publicznyprofil.github.io)

Сатира охватывает 2022–2026 годы: каждая планка скептиков — тест Тьюринга, «Змейка», единорог на одного человека — держится примерно 18 месяцев, прежде чем пасть. Рядом — заявления евангелистов: «четверть нового кода Google пишет ИИ», основатель с $1 млн ARR за 17 дней.

Разворот треда: страница, высмеивающая скептиков, сама оказывается ИИ-мусором, который фабрикует собственные доказательства. А настоящая претензия вообще не про возможности ИИ — про то, как руководители обращались с сотрудниками по пути к этим возможностям.

🚀Tech ★ 50 · 💬 121 · 4 июля · #ИИ#экономика#ChatGPT#Devin#METR

Профессор теории игр устроил экзамен на доверии. 50 студентов использовали ИИ (english.elpais.com)

Экономист из Брауновского университета, изучающий теорию игр, дал промежуточный экзамен на дом и на доверии, а финал — под наблюдением. Распределения оценок разошлись так резко, что, по его словам, минимум 50 из 86 студентов списали с ИИ. Его собственная кафедра лишь пожала плечами.

Тред был беспощаден: эксперт по теории игр, не сумевший предвидеть, что все смошенничают, сам построил эту ловушку. А преподаватель из Дартмута тем временем перестраивает курс по CS как «противоборство» со студентами, оптимизирующими оценку на единицу усилий.

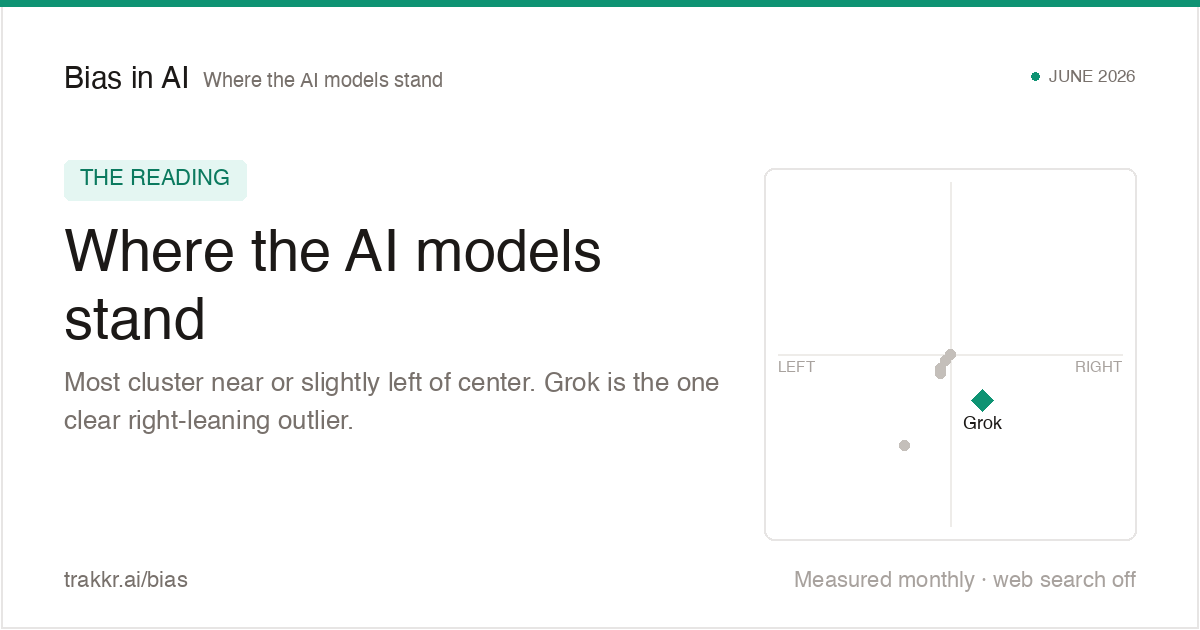
4392 ответа: карта политических уклонов ИИ и спор о том, кто их оценивал (trakkr.ai)

Trakkr прогнал шесть моделей через 61 политический вопрос, по двенадцать раз каждый, с выключенными веб-поиском и рассуждениями — чтобы повторить дефолт обычного пользователя. Классификатор оценивает каждый ответ от −1 до +1, судья из другой лаборатории перепроверяет выборку. Gemini выходит нейтральным, ChatGPT на −0,29, Grok на +0,21.

Автор сам пришёл в тред защищать свою оценку от главного возражения: вы меряете не модель, а зазор между ней и тем, кто писал рубрику. А самая меткая придирка оказалась про пиксели: серые линии тянут логотип Grok вправо и прячут факт — ChatGPT смещён влево сильнее, чем Grok вправо.

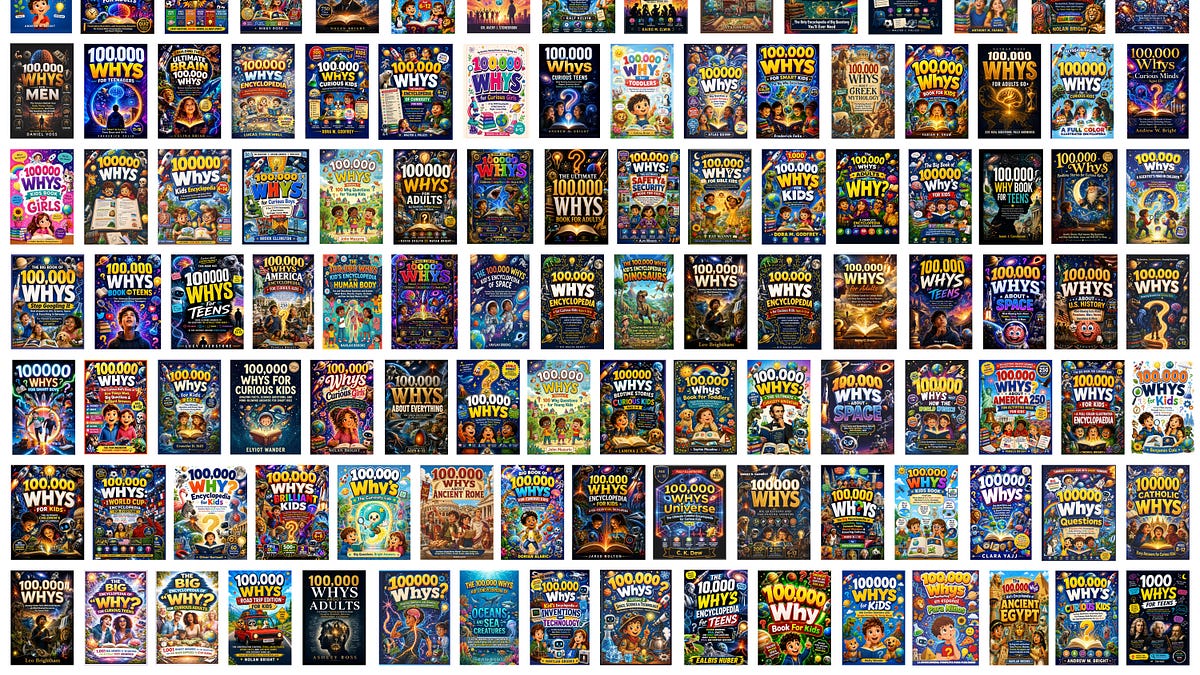
150 почти одинаковых ИИ-обложек детских книг доказывают: примета — это одинаковость (lcamtuf.substack.com)

Примета в виде одного тире мертва, доказывает автор. ИИ выдаёт совокупная одинаковость по множеству результатов, а не какой-то один артефакт.

Его доказательство — коллаж примерно из 150 сгенерированных ИИ обложек детских энциклопедий, многие из них бестселлеры в категории, и все гоняют по кругу одни и те же штампы и фамилии.

Тред назвал механизм, а затем усомнился, доказывает ли эта выборка хоть что-нибудь.

🚀Tech ★ 171 · 💬 100 · 22 июня · #ИИ#культура#веб#Amazon#ChatGPT#lcamtuf+1

Эссе требует начать ИИ с нуля. Тред разнёс эту идею в прах (xodium.net)

Пост «The AI Hate Progression» строится на одном тезисе: «Согласие просто исчезло. Его нет, когда ИИ входит в комнату в 90% случаев». Требование: начать с нуля, вшив согласие в основу.

Тред разделил гнев и уничтожил рецепт. Реакция tptacek: «начать с нуля» звучит настолько утопично, что даёт ему право не принимать это всерьёз. Другие указали, что согласие погибло ещё при веб-индексации в 1999-м, а настоящая мишень — гиперкапитализм в ИИ-маске.

OpenAI может срезать цены, чтобы отбиться от Anthropic. Тред спросил, как выжить, продавая доллар за 50 центов (cnbc.com)

Цинизм был конкретным: срезать цены сейчас, выйти на IPO, пока держится хайп, и комментарий, которому все кивали, — сколько можно продавать доллар за 50 центов?

Всплыл и настоящий раскол рынка: разработчики предпочитают Claude для кода, а ChatGPT владеет массовым сегментом. Ценовая война защищает потребительскую базу, на которую соперник толком и не нападает.

В 2019-м OpenAI заявила, что GPT-2 слишком опасна для релиза. Тред доказывает: правы были обе стороны (naokishibuya.github.io)

Пост возвращается к решению OpenAI в феврале 2019-го придержать модель на 1,5 млрд параметров, к девятимесячному исследованию, не нашедшему реальных злоупотреблений, и к полному релизу в ноябре.

Раскол резкий: один лагерь говорит, что социальный ущерб от дешёвого синтетического текста теперь астрономический, другой — что это был маркетинговый ход в духе «очень надеемся, что нас никто не воспримет всерьёз».

Синтез предложил дата-сайентист, строивший инструменты для GPT-2: оправданная осторожность в 2019-м, маркетинговый трюк применительно к моделям 2026-го.

Главный экономист Apollo: кризиса рабочих мест из-за ИИ нет. Тред отвечает: посмотрите, кто реально нанимает (apollo.com)

Аргумент сверху: если бы ИИ вытеснял работников, вакансии бы обвалились, а безработица выросла. Вместо этого рабочих мест больше, чем работников.

Контраргумент от тех, кто нанимает: убери здравоохранение — и большинство секторов стоят на месте или сжимаются, джуниорских вакансий в разработке почти ноль, а часть «вакансий» — это фантомы, которые ничего не стоит разместить.

Запомнилась фраза инженера из Google: сейчас тебя чуть ли не высмеивают, когда просишь штатную единицу.

Миллиард точек данных подтверждают: ИИ любит «Лучший X» — и ненадолго (x.com)

43,8% — это не оценка качества, а перепись. Листиклы доминируют в цитатах ИИ по той же причине, по которой они занимали Google: они составляют большую часть веба, и именно на этом вебе обучались модели.

В том же треде один ответ поставил срок: «шесть месяцев, пока чат-боты не начнут штрафовать этот паттерн». Та же ловушка двухлетнего SEO-цикла, новая платформа.