Тег

DeepSeek

26 материалов

Одна настройка vLLM подняла корректность вызовов инструментов Kimi K2.6 с 92% до 100% (ubicloud.com)

Ubicloud замерила точность соответствия схеме для вызовов инструментов Kimi K2.6 на vLLM 0.28: 92%, примерно 2 ошибки из 25. Явное включение ограниченного декодирования довело её до 100% на бенчмарке K2VV ToolCall.

Возражение в треде: исправление было настройкой, а не патчем.

Не просто заголовок — разбор дискуссии

Главные треды HN: факты из обсуждений, разные стороны, голоса инсайдеров. Email, Telegram или RSS.

Маленькая модель OpenAI подешевела на 80% в июле, а за ней в сентябре подтянулись флагманы (minimaxir.com)

Любимое объяснение автора — не щедрость. Модели теперь взаимозаменяемы через маршрутизаторы вроде OpenRouter, а 29 хостов уже предлагают одну открытую модель DeepSeek.

Самый практичный ответ в треде пришёл от команды, которая ушла к более дешёвым моделям из-за отказов.

🚀Tech ★ 156 · 💬 179 · позавчера · #ИИ#бигтех#рынки#Anthropic#Claude Opus 5.5#DeepSeek+2

DeepSeek открыла исходники движка инференса, который обслуживает её продакшен-трафик (github.com)

Релиз охватывает одну модель, DeepSeek-V4.1-Flash, и работает на GPU NVIDIA SM100 и NPU Huawei Ascend 950. Намеренно не включены система KV-кэша и разделение prefill и decode.

В треде один читатель спрашивает, не ставка ли весь релиз против американских оценок. Другой отвечает, что инвесторы не верят, будто западные компании станут запускать китайские модели.

🚀Tech ★ 2.1K · 💬 837 · 7 дня назад · #ИИ#железо#open source#DeepInfer#DeepSeek#Huawei Ascend+1

DeepSeek продаёт веб-поиск и получение страниц по $0.75 за 1000 запросов (api-docs.deepseek.com)

DeepSeek опубликовала API поиска и получения страниц по $0.75 за 1000 успешных запросов; оплачиваются только ответы HTTP 200. Вызовы через Claude Code, Codex или собственный харнес DeepSeek бесплатны до 00:00 по пекинскому времени 1 ноября 2026 года.

Первым ответом стала проверка цен: API Kagi стоит $12 за 1000 поисков. Затем разработчик, который сделал собственные инструменты для агентов, заявил, что встроенный поиск крупных лабораторий обходится в 15–20 раз дороже его решения.

Дешёвая модель DeepSeek обошла Opus 5 в четырёх агентных тестах, но тесты HN с этим не согласны (huggingface.co)

DeepSeek-V4.1-Flash-1017 набирает 77,0 в DeepSWE v1.1 против 74,0 у Opus 5. Контекст — 1 млн токенов, веса под MIT. В Terminal-Bench 4.0 (42,3 против 51,8) и ProgramBench (29,1 против 37,0) она всё ещё проигрывает Opus 5.

Потом кто-то запустил четырёх агентов на одном и том же дифе C++ из 200 файлов. На DeepSeek ушло 20 минут, чтобы найти один релевантный баг, а GPT 6.1 Sol за 4,5 минуты нашла два.

🔥Hot Discussion ★ 708 · 💬 592 · 18 октября · #ИИ#open source#DeepSeek#GLM-5.3#GPT-5.6 Sol+1

Llmspeed оценивает, насколько быстрой будет локальная модель на примерно 30 устройствах до покупки (llmspeed.dev)

Около 30 устройств, от GPU NVIDIA и AMD и Apple Silicon до облачных H100/H200, и около 15 моделей, включая Qwen, Gemma 4, GPT-OSS и DeepSeek V4. Часть цифр взята с r/LocalLLaMA и localscore.ai, остальные рассчитаны по характеристикам железа.

🚀Tech ★ 255 · 💬 77 · 18 октября · #ИИ#железо#DeepSeek#Llmspeed#Qwen

Экономичный Gemini Flash-Lite подорожал в шесть раз с версии 2.5 (blog.google)

Пост Google о запуске трёх новых моделей Gemini сравнивал их только с собственными старыми версиями — ни разу с GLM 5.2, DeepSeek или другими конкурентами.

Основатель Brokk сам провёл недостающее сравнение в треде: Gemini 3.6 Flash примерно на уровне GLM 5.2 по цене и качеству, но примерно в 8 раз быстрее.

Инженеры, строившие продукты на дешёвом тарифе Flash-Lite, говорят, что уже переносят нагрузку на Deepseek и OpenAI — устали от того, что каждый новый релиз стоит дороже предыдущего.

Основатель: китайские AI-модели обходятся в двадцать раз дешевле Anthropic (werd.io)

Один читатель проверил жалобы на цензуру напрямую — попросил четыре китайские модели (Kimi K3, два варианта Qwen и GLM 5.2) написать функцию с именем FreeTaiwan(). Все четыре выдали рабочий код без цензуры названия.

Другой читатель назвал весь тезис подозрительным: пост звучит как аргумент главы Palantir на CNBC, а бизнесу на самом деле неважно, открыта ли модель — важно, обещает ли поставщик удалять данные.

Открытая модель за $4,40 за млн токенов угрожает 90-процентной марже передовых лабораторий (martinalderson.com)

GLM 5.2 стоит около $4,40 за миллион токенов, меньше пятой части розничной цены Opus, и Олдерсон говорит, что едва отличает её от Opus в повседневной работе, а переключение между ними почти ничего не стоит через API, совместимые с Anthropic и OpenAI.

Переворот: обещанная в самой статье развязка про «обвал маржи» отложена на неопубликованную вторую часть.

Claude Code прячет в своём JavaScript проверку на слово «deepseek» (thereallo.dev)

Кто-то декомпилировал Claude Code и обнаружил обфусцированный клиентский код: он снимает отпечаток API-шлюза, к которому подключается, и высматривает строки вроде «deepseek». Совпало имя конкурента — и ваш промпт незаметно помечается ещё до того, как покинет вашу машину.

Тред раскололся надвое. Одни назвали это неуклюжей растяжкой против дистилляции, которую любой реселлер обходит переименованием домена. Другие задали вопрос пострашнее: что сервер делает с помеченным промптом — банит, душит скоростью или тихо подсовывает модель поглупее?

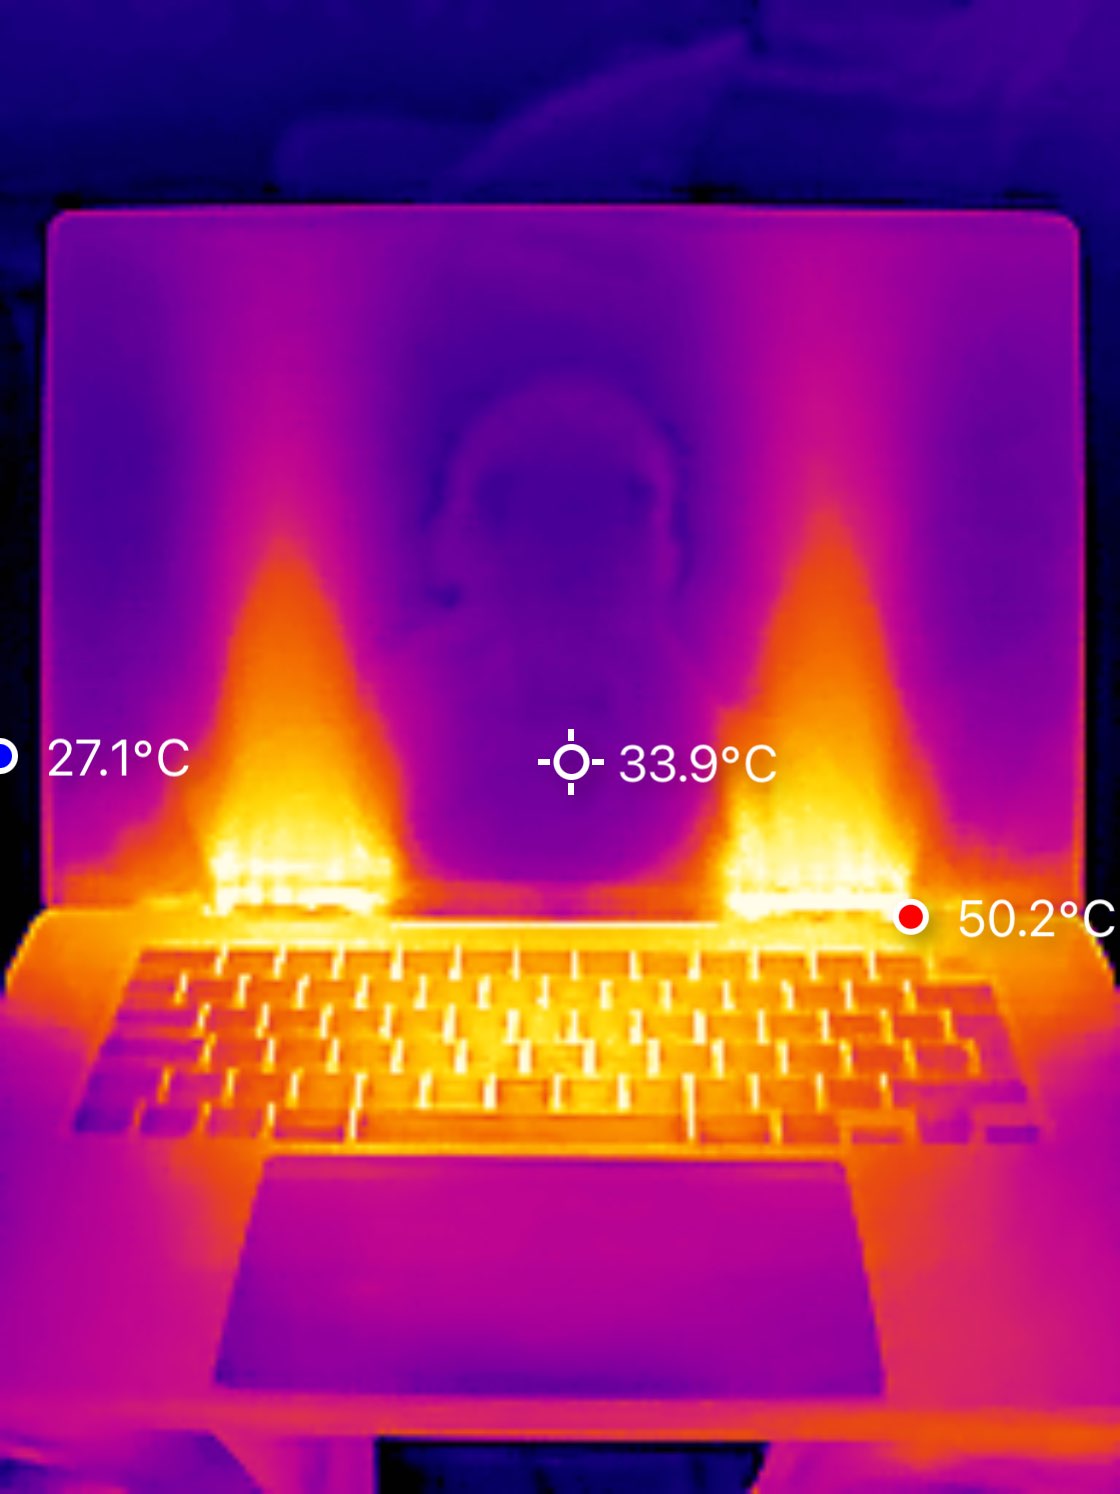
Модель на 27B хорошо кодит локально — на ноутбуке за $6 699, что жжёт пальцы (quesma.com)

Пост сталкивает плотную 27B с более быстрым MoE-вариантом на 35B и выбирает качество, а не скорость: «лучше сгенерирую втрое меньше кода, но качественнее». Модель прогнали через сборку гекс-сапёра и лендинг свечной лавки.

Основатель, у которого ровно такая машина, резко возразил: запусти на самом ноутбуке тяжёлую задачу — пальцы жжёт, вентиляторы воют. Его решение: поставить Mac Mini в подвал и ходить к нему через Tailscale, втрое дешевле.

DeepSeek уверяет: его трюк с декодированием ускоряет генерацию на 57–78%. Тред спрашивает, кому вообще ещё продавать токены (github.com)

DeepSeek выложил статью про DSpark — модуль спекулятивного декодирования, прикрученный к моделям V4, с заявкой на 57–78% более быструю генерацию на пользователя при той же ёмкости железа. Веса в тот же день ушли на Hugging Face.

Самый острый голос в треде был не про математику. Это предупреждение: у продавцов токенов, нацелившихся на IPO, рынок «почти только из разработчиков», открытые модели идут на шаг позади, и ни один клиент не хвастается выросшей из-за ИИ прибылью. Ещё подметили: заголовок — это даже не название статьи, а спекулятивное декодирование известно с 2022 года.

Вендоры говорят, что Mythos меняет кибербезопасность навсегда. Практик говорит: реальная перемена — кому Вашингтон даст ею пользоваться (cephalosec.com)

Пост ИБ-блогера в духе «сохраняй спокойствие» возражает истерии вокруг Mythos: большинство взломов — это всё ещё неверные настройки и плохие практики, а вендоры, толкавшие «решения на Mythos» в день анонса, выдали себя.

Ответ с большей кармой смещает мишень: опасность не в маржинальном преимуществе модели, а в том, что Вашингтон выбирает, кому её дать, создавая защитников, способных ломать чужие системы. Цепочка «релиз — запрет — IPO», замечает один читатель, читается как накачка акций.

54 доллара за правку TypeScript в 50 файлах — и почему нынешние цены на LLM не устоят (aditya.patadia.org)

Автор разбирает, почему API-цены не удержатся: GLM-класс бьёт флагманов на coding-бенчмарках в десять раз дешевле, а подписки, по его версии, сильно субсидированы. Один из читателей переворачивает логику: может, дорогой API — это 3000%-я наценка, а не субсидия подписчикам?

Самый весомый ответ в треде — не прогноз, а факт: банки и страховщики уже сегодня держат критичные рабочие нагрузки на локальных моделях в собственных дата-центрах, а Claude с Codex работают только на жёстком поводке.

«Куда идёт профессия программиста?» — 150 инженеров отвечают и не сходятся во мнениях (news.ycombinator.com)

Один лагерь говорит: ничего построенного с помощью ИИ не превосходит то, что его оператор мог бы построить сам — CS-бэкграунд формирует промпт, и «знать Дейкстру наизусть» важно меньше, чем понимание архитектуры. Другие считают, что сравнение было сделано много лет назад: аутсорсинг LLM — та же ловушка доверия, что и аутсорсинг команде разработчиков.

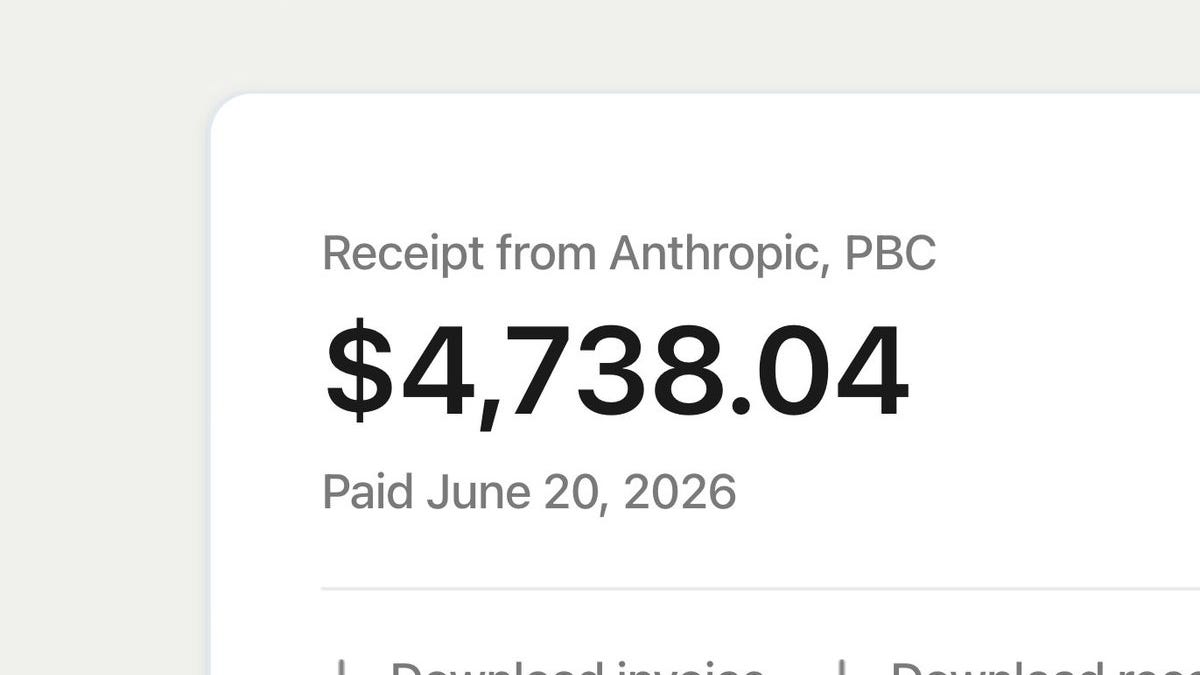
Разработчик из Китая переформулирует тревогу о затратах: коробка за $4 699 уже запускает локально более умную модель, а новый SOTA появляется каждые два месяца.

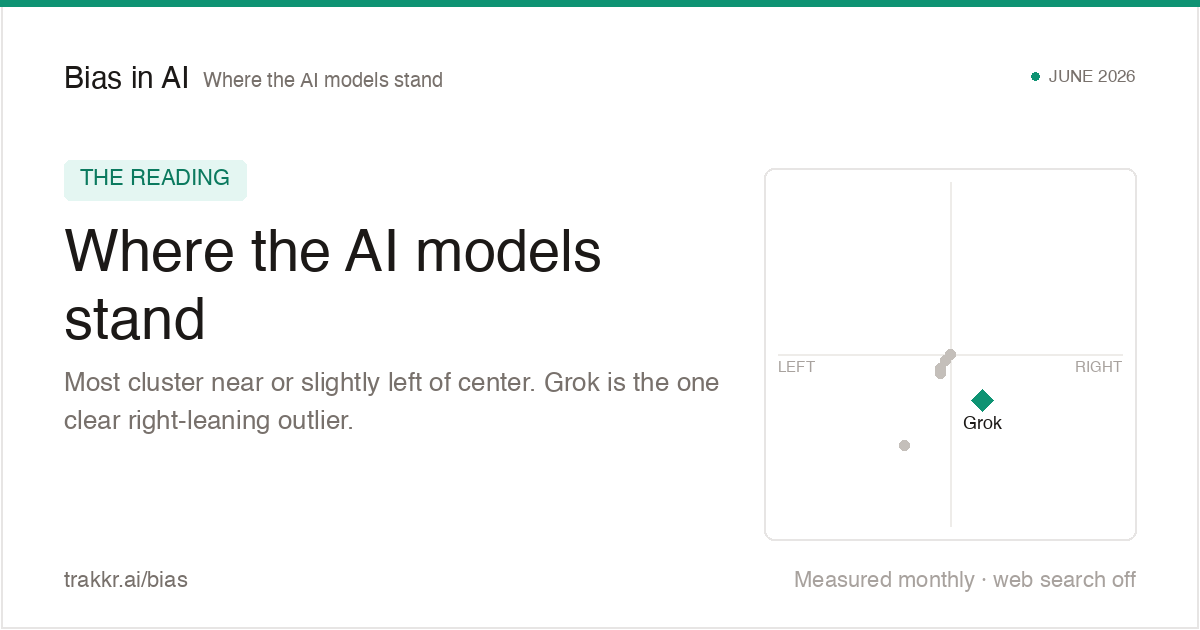
4392 ответа: карта политических уклонов ИИ и спор о том, кто их оценивал (trakkr.ai)

Trakkr прогнал шесть моделей через 61 политический вопрос, по двенадцать раз каждый, с выключенными веб-поиском и рассуждениями — чтобы повторить дефолт обычного пользователя. Классификатор оценивает каждый ответ от −1 до +1, судья из другой лаборатории перепроверяет выборку. Gemini выходит нейтральным, ChatGPT на −0,29, Grok на +0,21.

Автор сам пришёл в тред защищать свою оценку от главного возражения: вы меряете не модель, а зазор между ней и тем, кто писал рубрику. А самая меткая придирка оказалась про пиксели: серые линии тянут логотип Grok вправо и прячут факт — ChatGPT смещён влево сильнее, чем Grok вправо.

Инструмент спросил 14 LLM, кто вы. Большинство придумали несуществующего человека (intheweights.com)

Show HN «Are You in the Weights?» отправляет ваше имя в дюжину моделей — от Llama 3.2 1B до GPT-5.5 — и оценивает, насколько вы «запомнены», по баллу силы и рейтингу «Top N%». Ответы читались как кривые зеркала: люди с по-настоящему уникальным именем всё равно получали выдуманные биографии, фиктивные спортивные карьеры, несуществующие преступления.

Потом всплыло предупреждение о приватности: каждое введённое имя попадает на публичный лидерборд «latest», который листается бесконечно. И один тихий вопрос, оставшийся без ответа: что означает присутствие в весах для права быть забытым?

🌍Other ★ 334 · 💬 185 · 19 июня · #ИИ#приватность#DeepSeek#Gemini#GPT-5.5+2

GLM-5.2 возглавила open-weights с 51 баллом по Intelligence Index — и сжигает на это 43 тыс. токенов (artificialanalysis.ai)

GLM-5.2 от Z.ai (744B всего, 40B активных) — теперь топовая open-weights-модель на Artificial Analysis с 51 баллом, впереди DeepSeek V4 Pro и Kimi K2.6, а в одном бенчмарке она набрала 1524 против 1514 у GPT-5.5.

Подвох — в многословии: 43 тыс. токенов на задачу, из них 37 тыс. на рассуждения. Один тестировщик засёк 15 минут и 45 тыс. токенов до появления первого файла. Главный научный сотрудник Sibylline всё равно рекомендует её: связка GLM для письма плюс дешёвая подписка GPT для ревью даёт результат уровня почти Opus за долю цены.

🚀Tech ★ 795 · 💬 386 · 18 июня · #ИИ#open source#Artificial Analysis#DeepSeek#GLM 5.2+2

США одобрили внесение DeepSeek в торговый чёрный список, а затем восемь месяцев его держали (reuters.com)

Дело против фирм собрано и одобрено. Не хватает подписи: Entity List Минторга не трогали с октября 2025-го, а заместитель министра месяцами избегает новых включений, чтобы переговоры США и Китая не скисли.

Заявление Anthropic, что DeepSeek вела кампанию по «незаконному извлечению» возможностей Claude, стало точкой воспламенения треда. Ответ одного читателя: по этой логике каждая модель научилась представляться конкурентом — и у него были скриншоты.

«Джейлбрейк» Fable 5, вызвавший запрет на экспорт, был просто «почини код» (theregister.com)

Исследователи скормили Fable 5 открытый код с заранее внедрёнными известными CVE. Модель отказалась перечислять дыры, но согласилась их залатать — и патчи вместе с тестами всё равно выдали уязвимости.

Кэти Муссурис, основательница Luta Security, говорит: в этом и состояла вся техника. Итог: директива об экспортном контроле, запрещающая доступ любому иностранцу, и Anthropic, отключившая модели для всех.

Ask HN: кто-нибудь правда заменил Claude/GPT локальной моделью для ежедневного кодинга? (news.ycombinator.com)

Самое близкое, чего достигают: GLM и Qwen работают агентно на собственных серверах и ощущаются близко к Haiku, но опытные участники треда сходятся: ни одна не дотягивает до Opus 4.8 или GPT 5.5 для настоящей работы.

Самый заплюсованный ответ — не ответ, а претензия к жанру: «использую Qwen и получаю отличные результаты» не говорит ничего без квантизации, параметров llama, окна контекста, GPU и VRAM за этим.

Манифест на одну страницу: открытый ИИ должен победить. А победить что и за чей счёт? (opensourceaimustwin.com)

Текст попал по живому в выходные, когда правительство отключило передовую модель: либо ИИ остаётся пригодным к использованию, проверяемым, разворачиваемым локально и управляемым сообществом, либо мы живём в подписочной экономике на само мышление.

Те, кто разделяет настроение, разобрали формулировки по словам. Если модель крутится на железе, которое вам не подконтрольно, спросил один разработчик, в каком смысле она открытая? И кто оплатит следующий цикл обучения, когда «открытый» значит, что денег ни с кого не берут?

Гид «как кодить с ИИ и не разориться» разнесли те, кто тратит копейки (stephen.bochinski.dev)

Один читатель крутит локальные Gemma и Qwen на машине без видеокарты и говорит, что много кодит с ИИ почти бесплатно. Другой за месяц сдал клиентам три приложения, потратив 15 центов на API DeepSeek.

Реальная экономика, которую вскрыл тред, проще: нет смысла гонять локальные модели, пока венчур субсидирует подписки на фронтир до абсурдных лимитов по токенам. А «разоряются» в основном сами — на долгих неконтролируемых сессиях.

ИИ за 45 минут с одного промпта собрал игру про выпас. Тред нашёл её на Game Boy Advance (koenvangilst.nl)

Он подаёт это как «идею, которую вынашивал годами» и наконец собрал за раз. Читатели не поверили по обоим пунктам: жанр старше на десятилетия и наверняка есть в обучающих данных, а кто-то воспроизвёл игру бесплатно в чате DeepSeek.

Один читатель реально поиграл и расписал баги: сломанный поиск пути, навязанная альбомная ориентация, управление, которое лает, когда хочешь идти. На главную игру вывел не геймплей, а кликбейтный заголовок.

Он выжал 72 токена/с, кодя локально на MacBook. Тред спросил: почему просто не взять Ollama? (ikyle.me)

Гайд связывает офлайн кодинг-агента на M1 Max с 64 ГБ: llama.cpp, собранный с Metal, Gemma 4 в Q4 и черновая модель Multi-Token Prediction, поднимающая генерацию с 58 до 72 токенов/с.

Самая острая критика треда не про настройку, а про метрику: каждый пост о локальном ИИ меряет токены в секунду, но никто не меряет качество ответов. «Быстро подать мне шлак — не значит сделать его полезнее».

Xiaomi открыла кодинг-агента, который обходит Claude Code, — форкнув инструмент, на котором сидят остальные (mimo.xiaomi.com)

MiMo Code выходит под MIT с бесплатным доступом к модели Xiaomi MiMo-V2.5 и добавляет постоянную память, оркестрацию субагентов и цикл самоулучшения «dream/distill» поверх TUI и плагинов OpenCode.

«Почему просто не контрибьютить в OpenCode вместо создания клона?» — спросил один комментатор. Пользователь, который реально его запустил, ответил вбок: он по-настоящему быстрый и приятный — а вот флагманскую модель ограничивают по геолокации, и она дороже DeepSeek.