Открытая модель обходит Claude в поиске уязвимостей по 17 центов за баг
Semgrep прогнал десять конфигураций на одном и том же датасете IDOR. Открытая модель на 753 млрд параметров от Zhipu AI, получившая лишь промпт, обошла кодинг-агента Anthropic и обошлась примерно в $0,17 за найденную уязвимость.
Semgrep сравнил GLM 5.2 с Claude Code, GPT-5.5, DeepSeek V4 и другими на поиске Insecure Direct Object References в реальных open-source-приложениях. GLM 5.2 с голым промптом дала 39% по F1 — выше связки Claude Code SDK.
Но читатель заметил, что число из заголовка не сходится с таблицей: в тексте у Claude 32%, в таблице — 37%. А автор конкурирующего бенчмарка пришёл сказать, что GLM хороша, но не лучшая открытая модель из тех, что он тестировал.
Открытая модель с голым промптом обыгрывает кодинг-агента на детекции IDOR
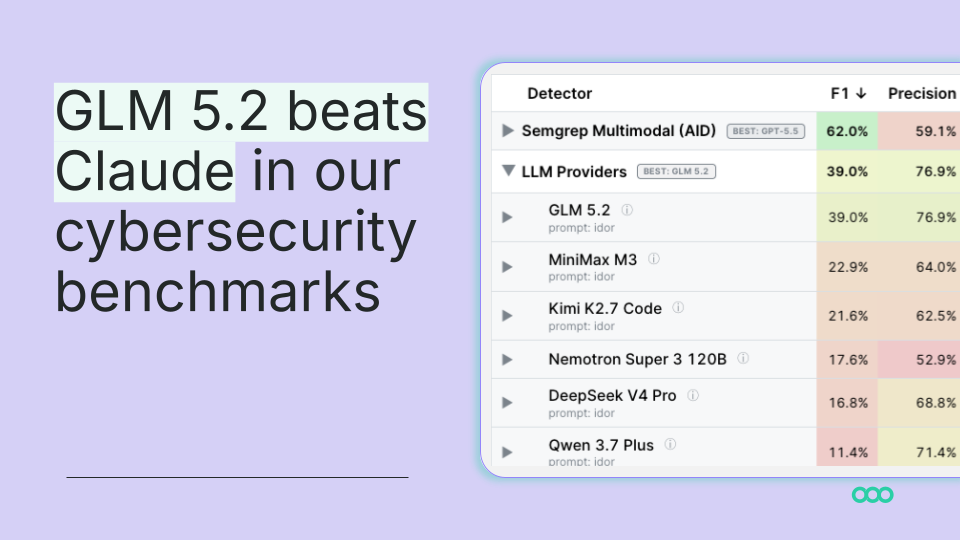
Бенчмарк Semgrep столкнул десять связок «модель + обвязка» на одной фиксированной задаче: поиск багов IDOR (Insecure Direct Object Reference — когда приложение раскрывает внутренний ID, не проверяя, имеет ли вызывающий право его видеть) в том же наборе реальных open-source-приложений, что и в их прошлом исследовании. Главный результат: GLM 5.2, открытая модель Zhipu AI, запущенная через Pydantic AI с одним лишь промптом, обошла конфигурацию Claude Code SDK — примерно за $0,17 за найденную уязвимость.
Полный рейтинг, метрика оценки F1:
| Место | Конфигурация | Обвязка | F1 |
|---|---|---|---|
| 1 | Semgrep Multimodal (GPT 5.5) | Semgrep Multimodal | 61% |
| 2 | Semgrep Multimodal (Opus 4.8) | Semgrep Multimodal | 53% |
| 3 | GLM 5.2 | Pydantic AI (только промпт) | 39% |
| 4 | Claude Code (Opus 4.6) | Claude Code SDK | 37% |
| 5 | Claude Code (Opus 4.8/4.7) | Claude Code SDK | 28% |
| 6 | MiniMax M3 | Pydantic AI (только промпт) | 23% |
| 7 | Kimi K2.7 Code | Pydantic AI (только промпт) | 22% |
| 8 | GPT-5.5 | Codex | 20% |
| 9 | Nemotron Super 3 120B | Pydantic AI (только промпт) | 18% |
| 10 | DeepSeek V4 | Pydantic AI (только промпт) | 17% |
Собственная обвязка Semgrep — мультимодальный конвейер, который сам отдаёт модели обнаруженные эндпоинты, — возглавляет таблицу с 53–61%. Их вывод: обвязка важнее модели, и самый широкий разрыв пролегает между конфигурациями, которым достаётся обнаружение эндпоинтов, и теми, которым нет.
Число из заголовка не сходится с собственной таблицей автора
Самая острая находка в треде оказалась бухгалтерской. В тексте празднуют, что GLM обошла Claude Code с её 32%, но четвёртая строка таблицы показывает 37%.
«Дважды в тексте F1-результат Claude Code назван как 32%, но в таблице стоит 37%… Любопытно, что это сильный признак того, что текст писали руками, а не с помощью LLM: скорее всего, человек ошибся при составлении таблицы». — комментатор, который проследил 32% по трём упоминаниям в тексте
Другие вовсе отказались принимать сравнение за чистую монету, потому что двух соперников запускали по-разному. GLM получила чистую обвязку Pydantic, Claude — Claude Code SDK, а победитель Semgrep работал на полном мультимодальном конвейере.
«Им стоило хотя бы прогнать Opus через ту же обвязку Pydantic, что и GLM. Сейчас это сравнение яблок с грушами. Где стоимость за уязвимость для всех моделей, кроме GLM? И без кода всё это не очень-то заслуживает доверия». — комментатор, требующий недостающих цифр стоимости по каждой модели
Прозвучало и терминологическое возражение: «Claude Code — это агентная обвязка, а не LLM. Claude — бренд, а не LLM», — написал пользователь HN с кармой 11k; выходит, «обходит Claude» сравнивает продукт-с-обвязкой с сырой моделью.
Голос автора конкурирующего бенчмарка: хороша, но не лучшая
Самый трезвый противовес пришёл от человека, который ведёт собственный бенчмарк поиска уязвимостей в духе Mythos.
«Я добавил GLM 5.2 в свой бенчмарк поиска security-багов, когда она вышла, и нашёл её крепким исполнителем, но не лучшей открытой моделью… Лучшими открытыми в исходном бенчмарке были DeepSeek V4 Pro или MiMo 2.5 Pro». — SwellJoe, работает над Virtualmin и ведёт бенчмарк will-it-mythos
Он добавил наблюдение, бьющее по самому продуктовому посылу Semgrep: если дать моделям open-source-Semgrep как инструмент, часть из них работала хуже, и ни одна не работала лучше; его версия в том, что инструмент слабо представлен в обучающих данных, поэтому модель тратит фокус на то, чтобы научиться им управлять. Похвалы из ежедневной практики были реальными, но смешанными: один активный пользователь LLM назвал GLM «хорошей рабочей лошадкой», на которой за выходные собрал Rust-агента за $20; консультанту по Rust она понравилась, но он не нашёл экономичного способа её реально запускать, назвав тариф z.ai завышенным и заметив, что плата за токены выгоднее, если нет подписки на Claude или Codex. Число, которое стоит унести из этого бенчмарка, — не 39%, а то, что одна недостающая колонка с обвязкой превратила сравнение «как с как» в маркетинговый пост, который несколько читателей разобрали построчно.
Получайте такие разборы каждый день
Главные истории Hacker News — на email, в Telegram или RSS.
Он декомпилировал камеру Flock и нашёл метки «человек», «собака», «велосипед» — не только номера
Человек, помогавший выгнать Flock из двух городов Орегона, снял код с легально полученного устройства. Его бортовой детектор объектов уже размечал людей и велосипеды, а не только автомобильные номера.