Тег

GLM 5.2

10 материалов

Экономичный Gemini Flash-Lite подорожал в шесть раз с версии 2.5 (blog.google)

Пост Google о запуске трёх новых моделей Gemini сравнивал их только с собственными старыми версиями — ни разу с GLM 5.2, DeepSeek или другими конкурентами.

Основатель Brokk сам провёл недостающее сравнение в треде: Gemini 3.6 Flash примерно на уровне GLM 5.2 по цене и качеству, но примерно в 8 раз быстрее.

Инженеры, строившие продукты на дешёвом тарифе Flash-Lite, говорят, что уже переносят нагрузку на Deepseek и OpenAI — устали от того, что каждый новый релиз стоит дороже предыдущего.

Не просто заголовок — разбор дискуссии

Главные треды HN: факты из обсуждений, разные стороны, голоса инсайдеров. Email, Telegram или RSS.

Проблема доверия у Anthropic: 9 100 открытых issue и откат биллинга (raheeljunaid.com)

Спусковым крючком стало изменение биллинга от 15 июня 2026 года: оно разбило потребление на отдельные пулы и стало тарифицировать «кредиты Agent SDK» по стандартным ставкам API, примерно в 15–30 раз дороже подписки. После волны недовольства Anthropic поставила изменение на паузу и откатила.

Оговорка самого автора, брошенная в тред: для сценария автодополнения не нужна лучшая модель, достаточно приличной.

Открытая модель за $4,40 за млн токенов угрожает 90-процентной марже передовых лабораторий (martinalderson.com)

GLM 5.2 стоит около $4,40 за миллион токенов, меньше пятой части розничной цены Opus, и Олдерсон говорит, что едва отличает её от Opus в повседневной работе, а переключение между ними почти ничего не стоит через API, совместимые с Anthropic и OpenAI.

Переворот: обещанная в самой статье развязка про «обвал маржи» отложена на неопубликованную вторую часть.

Гайд продаёт ферму за $40 тысяч ради «почти Opus». Тред: это 17 лет подписки (github.com)

Гайд практичен: от стартовой сборки за ~$2k (две RTX 3090) под модель на 27B до топовой за ~$40k (четыре RTX 6000 Pro, 384 ГБ) под урезанный GLM-5.2 на ~80 токенов/сек. Секрет — вкладываться в объём VRAM и дешёвое переключение PCIe4, а не в дорогую инфраструктуру.

Читатели, которые сами собирают фермы, топовый вариант не одобряют. Один оценивает такой же интеллект в 8×H200 (~$400k, а не $40k); другой, потративший $4 200, говорит, что даже это не окупится против субсидированных токенов сегодня.

🚀Tech ★ 294 · 💬 128 · 4 июля · #ИИ#железо#Claude Opus#GLM 5.2#Qwen+1

ZCode от Z.ai догоняет Claude Code на GLM-5.2 и сильно похож на Codex (zcode.z.ai)

Тарифы идут от $16,20 до $144 в месяц, а подписчики GLM Coding получают скидку на квоту внутри ZCode: в пиковые часы (14:00–18:00) множитель падает с 3x до 2x, вне пика — с 1x до 0,67x, то есть примерно в 1,5 раза больше лимита. Сам базовый лимит в токенах нигде не назван.

Разработчики спрашивают, почему лаборатория, открывающая веса своих моделей, держит обвязку закрытой. А агент под контролем китайской компании с полным доступом к системе вызвал прямые предупреждения о доверии.

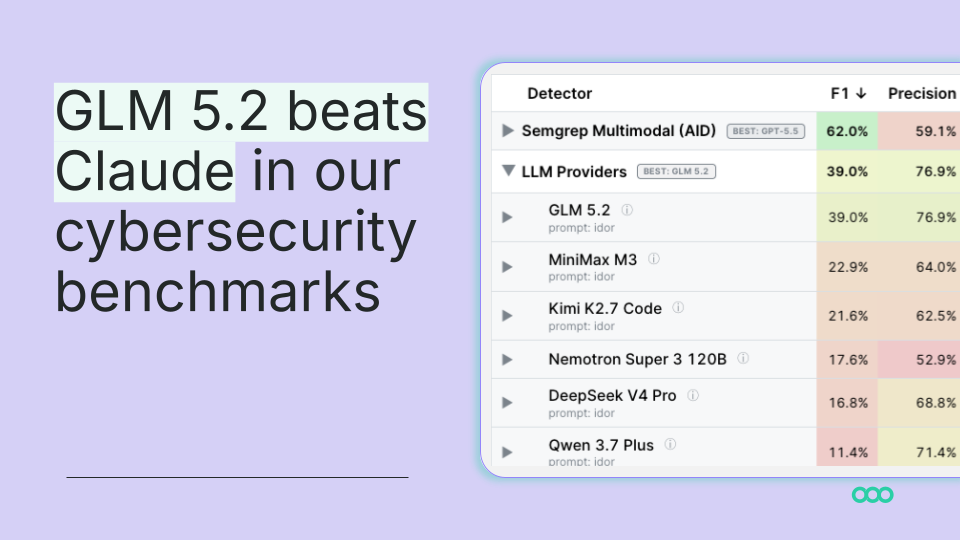
Открытая модель обходит Claude в поиске уязвимостей по 17 центов за баг (semgrep.dev)

Semgrep сравнил GLM 5.2 с Claude Code, GPT-5.5, DeepSeek V4 и другими на поиске Insecure Direct Object References в реальных open-source-приложениях. GLM 5.2 с голым промптом дала 39% по F1 — выше связки Claude Code SDK.

Но читатель заметил, что число из заголовка не сходится с таблицей: в тексте у Claude 32%, в таблице — 37%. А автор конкурирующего бенчмарка пришёл сказать, что GLM хороша, но не лучшая открытая модель из тех, что он тестировал.

Meta привязала аттестацию к расходу токенов. Инженеры свели двух агентов болтать весь день (12gramsofcarbon.com)

Эссе доказывает, что tokenmaxxing умер лишь потому, что субсидируемые токены подорожали, а грядущий сдвиг — автор называет его «накопительная правильность», когда больше потраченных токенов надёжно покупают лучшие ответы, — воскресит его на дешёвых открытых моделях.

Тред, полный людей, сидевших на тех самых VP-совещаниях, отказался от мягкой трактовки: один назвал это «идиотским ходом на хайпе», другой рассказал, что ему велели одобрять PR, не читая их.

«Запусти GLM-5.2 локально» — мелким шрифтом: 512 ГБ ОЗУ и два 3090 (unsloth.ai)

Unsloth выпустил гайд по локальному запуску открытой GLM-5.2 — модели, которая, по ощущениям многих, закрывает разрыв с топовыми проприетарными.

Но владельцы железа в треде быстро приземлили эйфорию: «помещается в 256 ГБ» означает жёсткое квантование и черепашью скорость, а комфортный запуск — это 512 ГБ ОЗУ и пара видеокарт.

Главная мысль не про железо: открытая модель такого уровня показывает, что у OpenAI и Anthropic не магический ров, а лишь фора во времени.

GLM-5.2 возглавила open-weights с 51 баллом по Intelligence Index — и сжигает на это 43 тыс. токенов (artificialanalysis.ai)

GLM-5.2 от Z.ai (744B всего, 40B активных) — теперь топовая open-weights-модель на Artificial Analysis с 51 баллом, впереди DeepSeek V4 Pro и Kimi K2.6, а в одном бенчмарке она набрала 1524 против 1514 у GPT-5.5.

Подвох — в многословии: 43 тыс. токенов на задачу, из них 37 тыс. на рассуждения. Один тестировщик засёк 15 минут и 45 тыс. токенов до появления первого файла. Главный научный сотрудник Sibylline всё равно рекомендует её: связка GLM для письма плюс дешёвая подписка GPT для ревью даёт результат уровня почти Opus за долю цены.

🚀Tech ★ 795 · 💬 386 · 18 июня · #ИИ#open source#Artificial Analysis#DeepSeek#GLM 5.2+2

Китайская GLM 5.2 вышла в открытых весах в тот час, когда Вашингтон отключил Fable (twitter.com)

Заметка основателя к запуску звучит как манифест: «Фронтирный интеллект принадлежит всем… Путь к AGI не должен быть огорожен высокими стенами». Тайминг выверен: пост появился ровно тогда, когда Anthropic получила правительственное письмо.

Три китайские лаборатории за считаные дни выпустили открытые модели, пока американская гасла, — контраст, который один разработчик назвал фантастикой. Пользователь первого дня оценил GLM 5.2 между Sonnet и Opus, с привычной для Z.ai оговоркой про надёжность.