GPT-5.6 нарисовал Мону Лизу за $7,74, а Claude потратил $160
Четырём ИИ-моделям выдали одинаковый набор виртуальных цветных карандашей и функцию оценки, а затем попросили перерисовать Мону Лизу мазок за мазком с логированием каждого шага. Одна закончила быстро и дёшево, другая работала намного дольше — и всё равно не заняла первое место.
GPT-5.6 Sol понадобилось 29 логированных вызовов инструментов, чтобы закончить; Claude Fable 5 сделал 54 — с тем же виртуальным набором карандашей: рисовать, размазывать, стирать, подглядывать на цель, — внутри бенчмарка, который оценивает каждый мазок в токенах и долларах.
Таблица с баллами тихо противоречит выводу самой статьи: показатель схожести у Gemini оказался выше, чем у Sol, на обеих картинах, но именно Sol авторы называют «безоговорочным лидером». Читатель Hacker News не поверил в статью вовсе, назвав весь бенчмарк написанным ИИ.
GPT-5.6 набросал Мону Лизу за $7,74. Claude потратил $160,58 на тот же портрет
Четырём визуальным моделям выдали одинаковый набор виртуальных цветных карандашей и отпустили рисовать две знаменитые картины в тесте под названием Canvas Arena. Харнесс, выложенный в открытый доступ на GitHub, даёт каждой модели одни и те же восемь инструментов: черновик для рассуждений, кнопки подглядывания на цель и на собственный холст, управление цветом, кистью и нажимом, плюс рисование, размазывание, стирание и очистку. Ничего не генерируется одним запросом — каждый мазок это отдельный логированный вызов инструмента с ценой в токенах и долларах.
Четыре участника — GPT-5.6 Sol, Claude Fable 5, Grok 4.5 и Gemini 3.6 Flash. Два сюжета оценивались по структурному сходству (SSIM) с реальной референсной фотографией: Мона Лиза и «Звёздная ночь». Ещё пять запросов — пожилой рыбак, закат над океаном, роза в вазе, полосатый кот на подоконнике, интерьер хижины с камином — не имели цели для сравнения, только текстовое описание для работы.
Четыре версии Моны Лизы в итоге напоминают не подделки, а четырёх разных студентов, копирующих одну и ту же фотографию, каждый со своими особенностями.
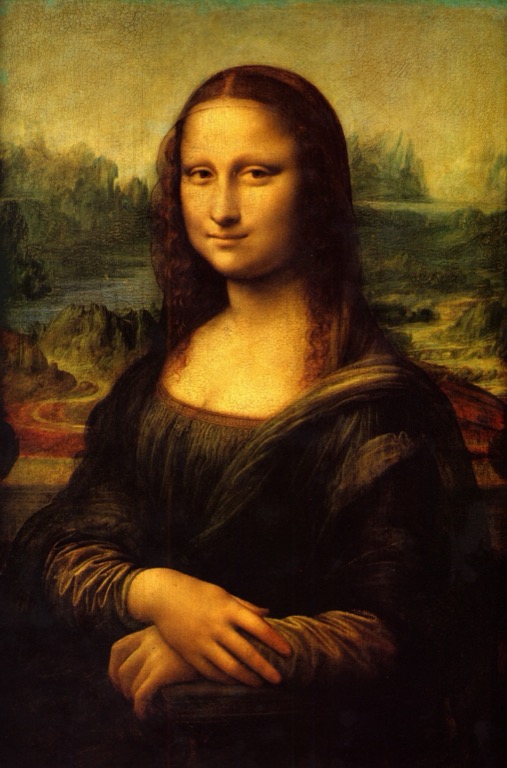
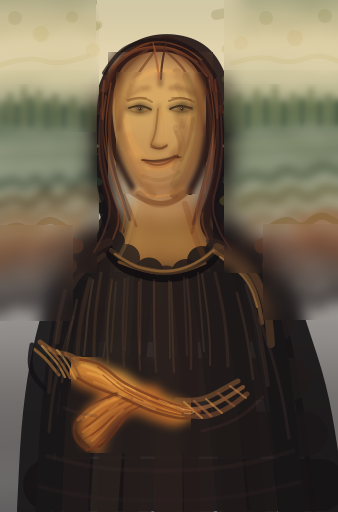
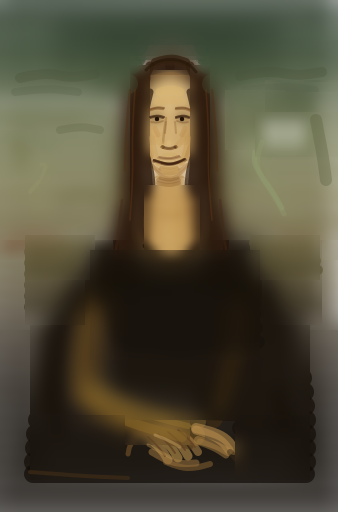
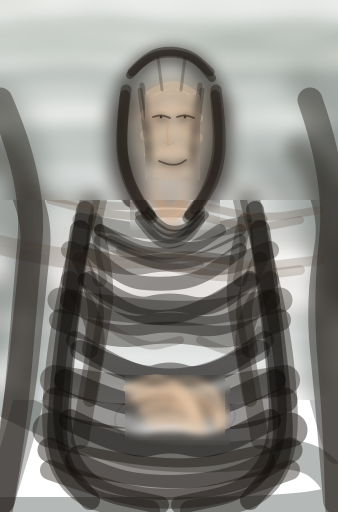
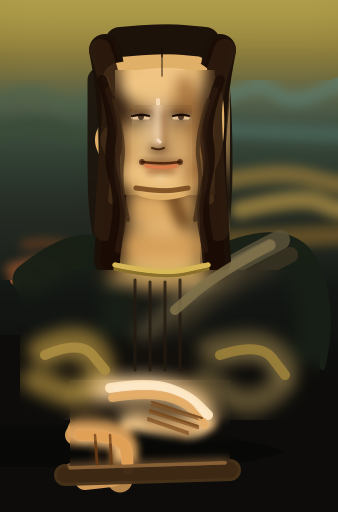
Во что обошлись каждой модели две картины
| Модель | Стоимость | Токены | Ср. число шагов |
|---|---|---|---|
| GPT-5.6 Sol | $7.74 | 3.4M | 29 |
| Grok 4.5 | $9.21 | 34.0M | 99 |
| Gemini 3.6 Flash | $12.87 | 27.7M | 73 |
| Claude Fable 5 | $160.58 | 14.6M | 54 |
Счёт Fable — самый странный. Модель сожгла меньше токенов, чем и Grok, и Gemini, но обошлась примерно в 20 раз дороже, чем Sol, — как отмечает сама статья. Разрыв не в многословности — дело в цене за токен у самой модели, которая рисует.
Оценка, не совпадающая с похвалой в самой статье
| Цель | GPT-5.6 Sol | Gemini 3.6 Flash | Claude Fable 5 | Grok 4.5 |
|---|---|---|---|---|
| Мона Лиза | 0.325 | 0.337 | 0.286 | 0.151 |
| Звёздная ночь | 0.130 | 0.172 | 0.153 | 0.039 |
По SSIM Gemini 3.6 Flash на самом деле обошёл Sol на обеих картинах. Авторы всё равно называют Sol «безоговорочным лидером», хваля его за более дешёвый, быстрый и обаятельный результат, а не за сырое число схожести. Это оправданное решение с точки зрения стиля — просто не то, что подтверждает их собственная таблица с точки зрения точности.
В том же отчёте есть ещё одна деталь: во всех восьми оценённых прогонах финальный рисунок каждой модели оказался хуже лучшей версии, достигнутой в середине сессии. Получив больше мазков в запасе, каждая модель дорисовала себя до результата хуже уже достигнутого.
Первая реакция треда: «По-моему, это просто реклама»
Скепсис появился уже в первых ответах.
«По-моему, это просто реклама».
— аккаунт HN, активный с 2008 года, с кармой почти 57 000
Комментатор на HN с 2015 года пришёл к тому же подозрению с другой стороны, в трёх словах: «Статья написана ИИ».
Ни один не привёл доказательств помимо интуиции. Но из сорока ответов в треде никто не выступил в защиту текста как однозначно искреннего.
Проблема Grok с «Ecce Homo»
Единственная точка почти полного согласия в треде — результат Grok 4.5.
«Sol лучший в каждом случае, а Grok выглядит как работа того человека, который ‘починил’ ту картину с Иисусом...»
— разработчик, чья биография ссылается на его собственный опенсорсный игровой проект на GitHub
Отсылка — к печально известной провальной реставрации испанской фрески 2012 года, и она прижилась: таблица с баллами уже отметила Grok как явного аутсайдера, а тред просто дал этому аутсайдеру имя.
На что на самом деле идут 160 долларов, по мнению треда
Один ответ сфокусировался на модели, за которую никто не ожидал болеть.
«У GPT 5.6 Sol были два лучших рисунка… но ещё более впечатляющим было то, насколько он эффективен по деньгам/времени/токенам по сравнению с Fable… OpenAI тихо совершенствуется в инференсе — это станет растущим отличием даже на фоне открытых моделей».
— сооснователь стартапа для документного воркфлоу
Другой ответ смотрел не на цифры, а на то, какими рисунки казались на ощупь.
«GPT-5.6 Sol здесь просто нокаутирует. Некоторые результаты по-настоящему человечны и обаятельны. Прямоугольный инструмент размазывания сам по себе странный, но забавно смотреть, как модели пытаются им пользоваться».
— комментатор с кармой почти 23 000
В сумме настоящий спор в треде не о том, кто нарисовал самую красивую Мону Лизу. Он о том, что преимущество Sol проявляется именно в бенчмарке, построенном так, чтобы его вознаграждать: замкнутый контур между целевым изображением и функцией оценки, где дешёвая, экономная по токенам модель почти по построению набирает очки за эффективность. Куда более сложная проверка — что случится с этим разрывом в цене, когда не будет референсного изображения для сверки.
Получайте такие разборы каждый день
Главные истории Hacker News — на email, в Telegram или RSS.
Историк заявил: кнопка «обратить в веру» в Age of Empires — это этническая чистка
В Age of Empires единственный способ поглотить вражеский город — послать жреца и обращать жителей одного за другим. Историк Брет Деверо считает, что это ближе всего серия подходит к изображению настоящей империи — и даже это больше похоже на этническую чистку, чем на управление государством.