Kimi K3.1 Pro занял четвёртое место в индексе Artificial Analysis, обогнав GPT-6 Astra
Новая открытая модель Moonshot набирает 65,7% на Terminal-Bench 4.0, на 0,7 пункта позади Claude Opus 5.5. Компания обещает полные веса к 4 ноября.
У Kimi K3.1 Pro окно контекста в 1 миллион токенов, а вариант Highspeed работает в 2–3 раза быстрее. В индексе Artificial Analysis модель набирает 55 баллов и занимает четвёртое место, но на оценку потратила 150 млн токенов против медианы 87 млн.
Moonshot также говорит, что намеренно оставила открытые веса ниже наступательных киберспособностей собственного конвейера.

Что выпустила Moonshot
Kimi K3.1 Pro — это постобученная версия K3, которую компания называет «открытой моделью класса 3T» с окном контекста в 1 миллион токенов. Вариант Highspeed работает в 2–3 раза быстрее. Полные веса обещаны до 4 ноября 2026 года; цены API указаны на отдельной странице.
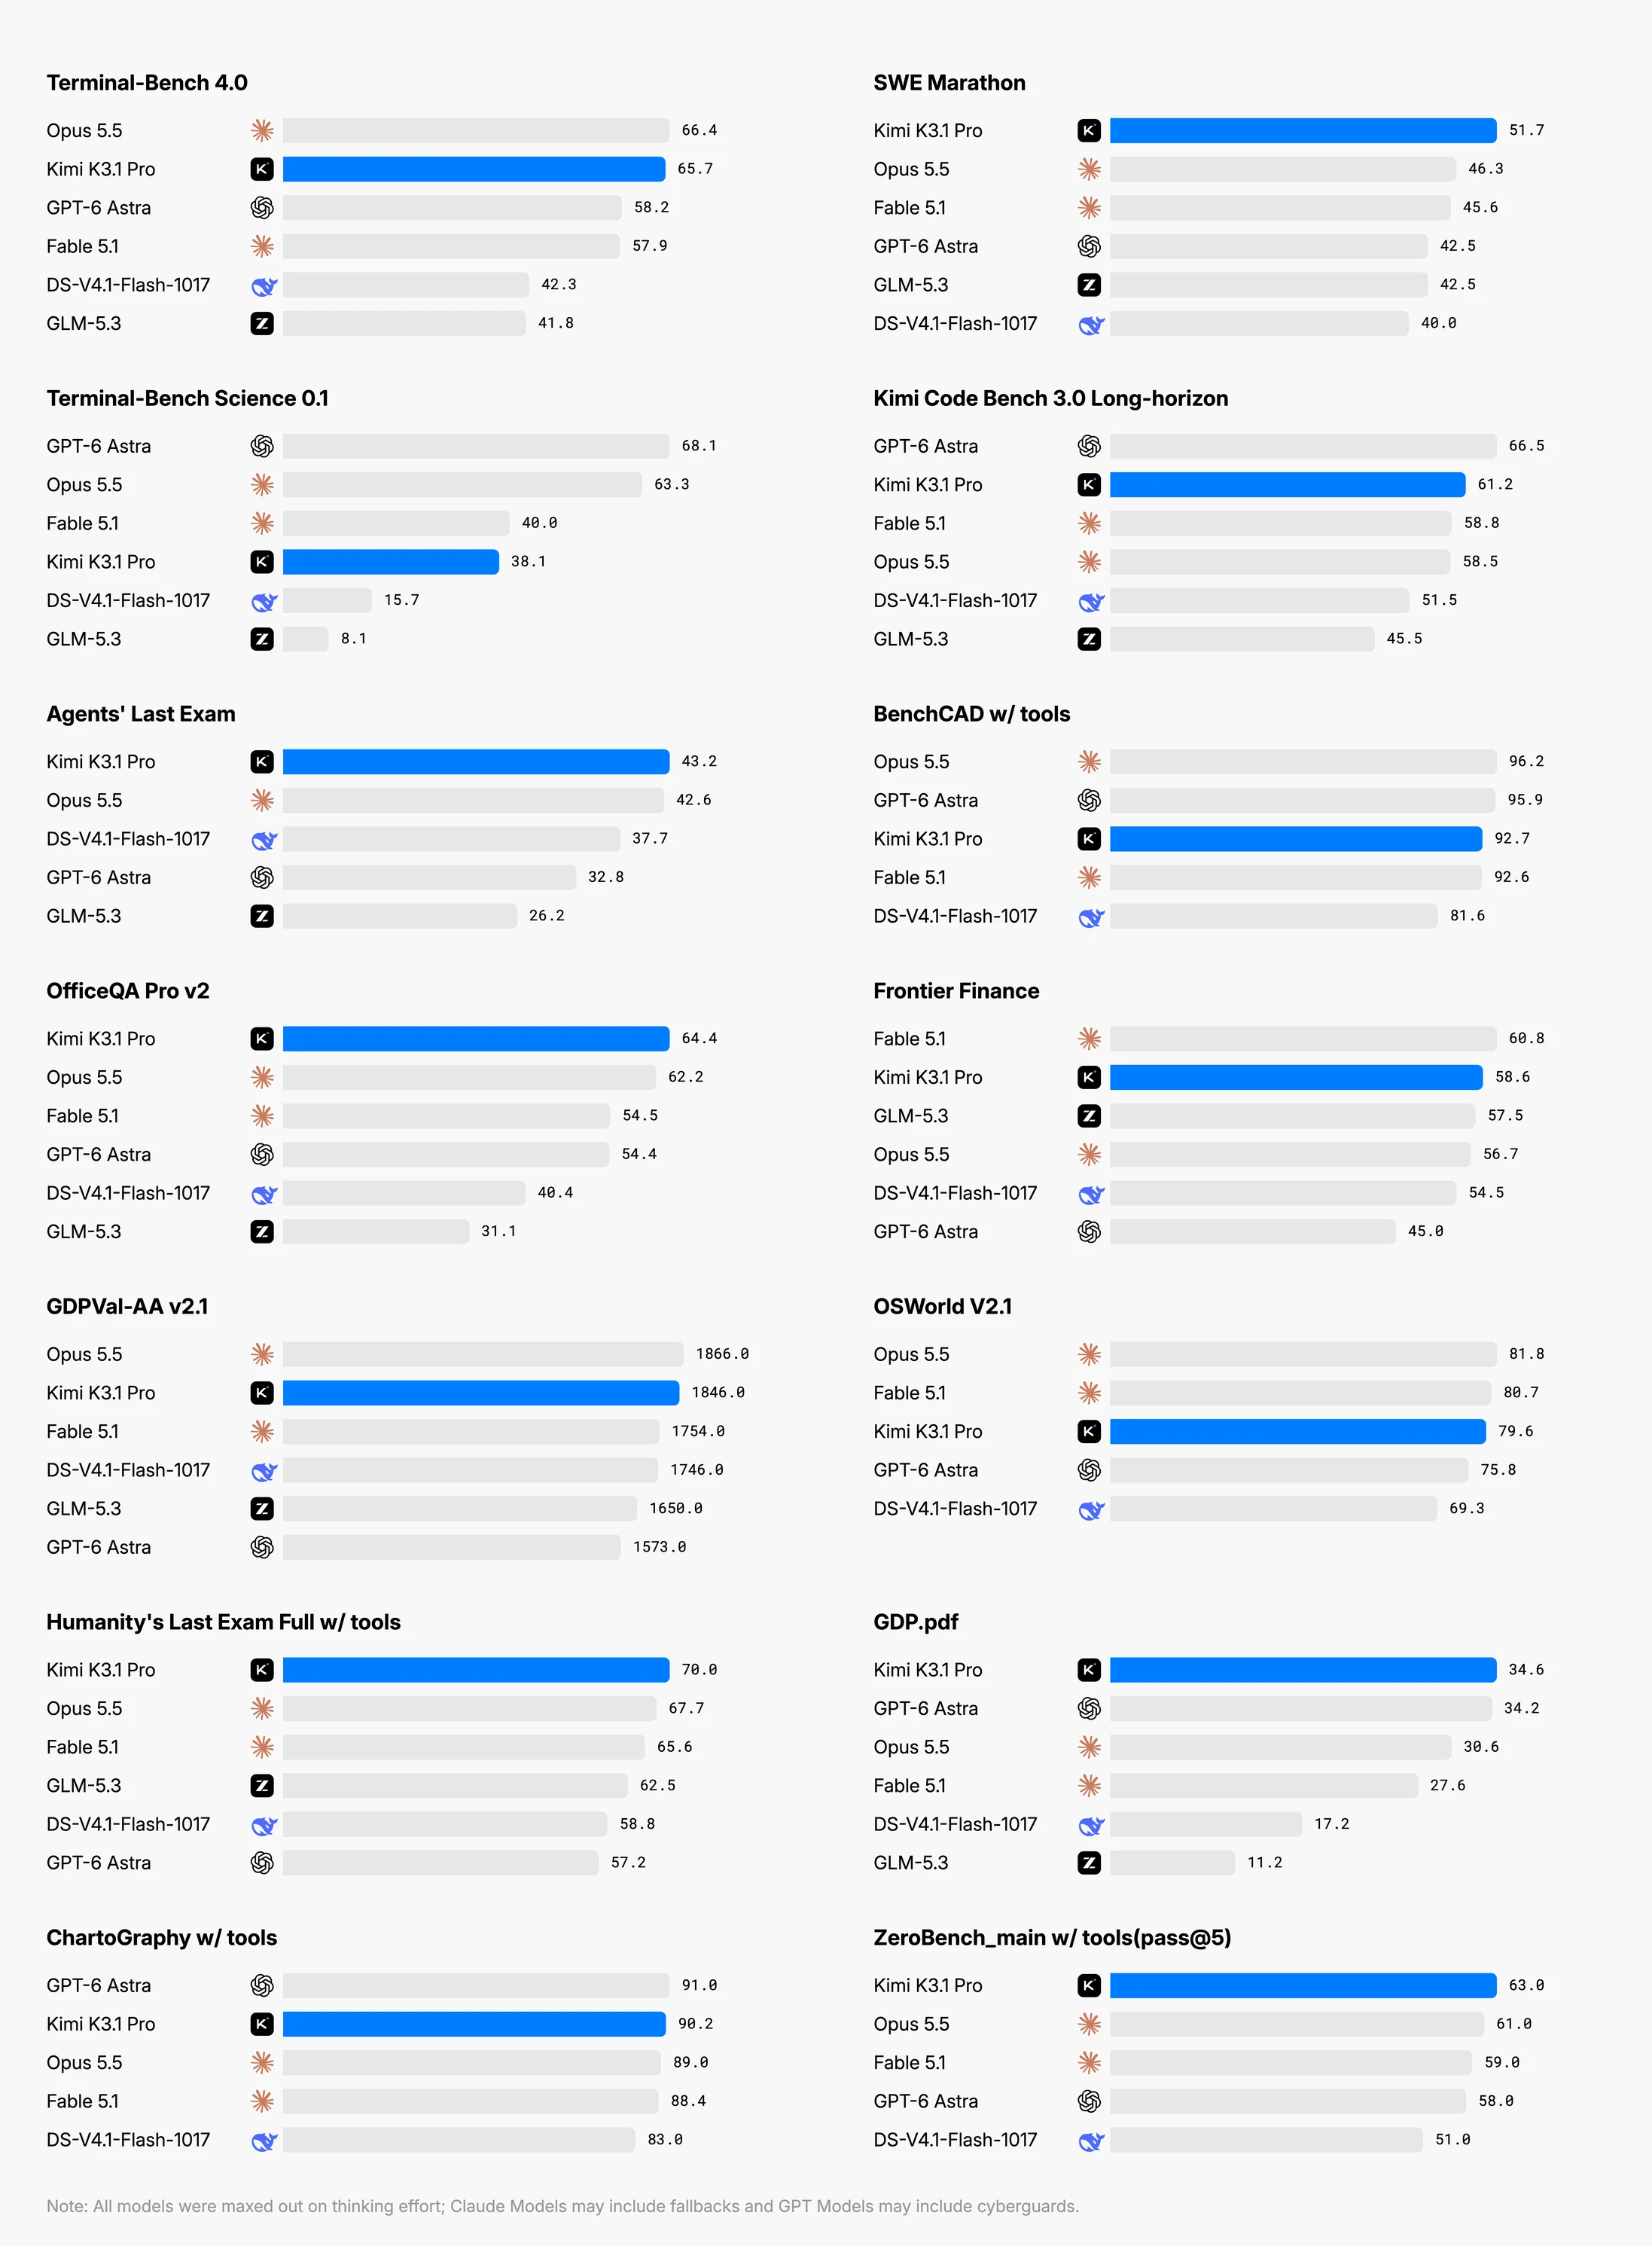
На Terminal-Bench 4.0 модель набирает 65,7%, опережая GPT-6 Astra (58,2%) и немного уступая Claude Opus 5.5 (66,4%). На внутреннем стресс-тесте Moonshot по галлюцинациям доля ошибочных утверждений снизилась с 23,4% (K3) до 8,3%. Компания подчёркивает, что это стресс-тест, а не типичная ежедневная частота ошибок.
Независимые цифры пришли в тред
Max Woolf, бывший старший дата-сайентист BuzzFeed, опубликовал сторонний результат: модель набирает 55 баллов в Artificial Analysis Intelligence Index, занимая четвёртое место в общем зачёте, и «обходит и GPT-6 Astra, и Fable 5.1», причём работает быстрее обеих. Цена этого — многословность: за время оценки модель сгенерировала 150 млн токенов против медианы 87 млн.
Предложение о киберспособностях
В посте Moonshot говорит, что стремится «не выпускать открытые веса, которые бы расширяли абсолютную границу киберспособностей». Один читатель воспринял это как признание: комментатор, цитирующий этот фрагмент, спросил: «То есть они признают, что могли бы сделать больше, но не делают?» В таблице самой Moonshot видно, как работают меры: 81,0% на тесте киберзащиты xdev-bench-hard при pass@3, против 90,5% у чекпоинта без мер снижения и 33,3% у K3.
Бенчмарки против повседневного использования
Скепсис высказал читатель, который пользовался предыдущими моделями: модели Kimi «часто» получают более высокие оценки в бенчмарках, чем DeepSeek, Qwen и GLM, но на его задачах работали хуже. Другой читатель проверил новую модель на задаче с написанием Pac-Man и обнаружил, что она сравнялась с Sonnet 5.5 со счётом 93: $0,68 и 11 минут против $1,61 и 14 минут. Практический вывод: судить по собственной задаче и закладывать бюджет на избыточную многословность.
Получайте такие разборы каждый день
Главные истории Hacker News — на email, в Telegram или RSS.
Google: данные Gmail и Фото могут уйти в рекламу, если разрешить их другим сервисам
The Verge написал, что Google «может» использовать данные Gmail и Google Фото для таргетинга рекламы. Решает исключение в конце фразы, и никто не согласен, насколько сложно его не задеть.