GPU ждал не вычислений, а CPU: Moondream отыграла 35% на B200
GPU простаивал не потому, что закончилась работа. Он ждал, пока CPU скажет, что считать дальше. Инженеры Moondream переписали цикл декодирования так, чтобы эти двое больше не ждали друг друга.
При генерации токенов GPU часто простаивает не из-за нехватки вычислений, а потому что CPU ещё не закончил подготовку следующего токена. Moondream называет разрыв «пузырём GPU» и переписала движок Photon так, чтобы его спрятать: следующий проход вперёд накладывается на сэмплинг предыдущего.
Выигрыш растёт вместе с мощностью машины. На RTX 3090 приём даёт около 6,5%, а на B200, где синхронизация с CPU занимает бóльшую долю крошечного прохода в 2,4 мс, уже 35,4%. Инженер по инференсу возразил: цифра так велика лишь потому, что модель маленькая.
GPU простаивал, и виноват был CPU
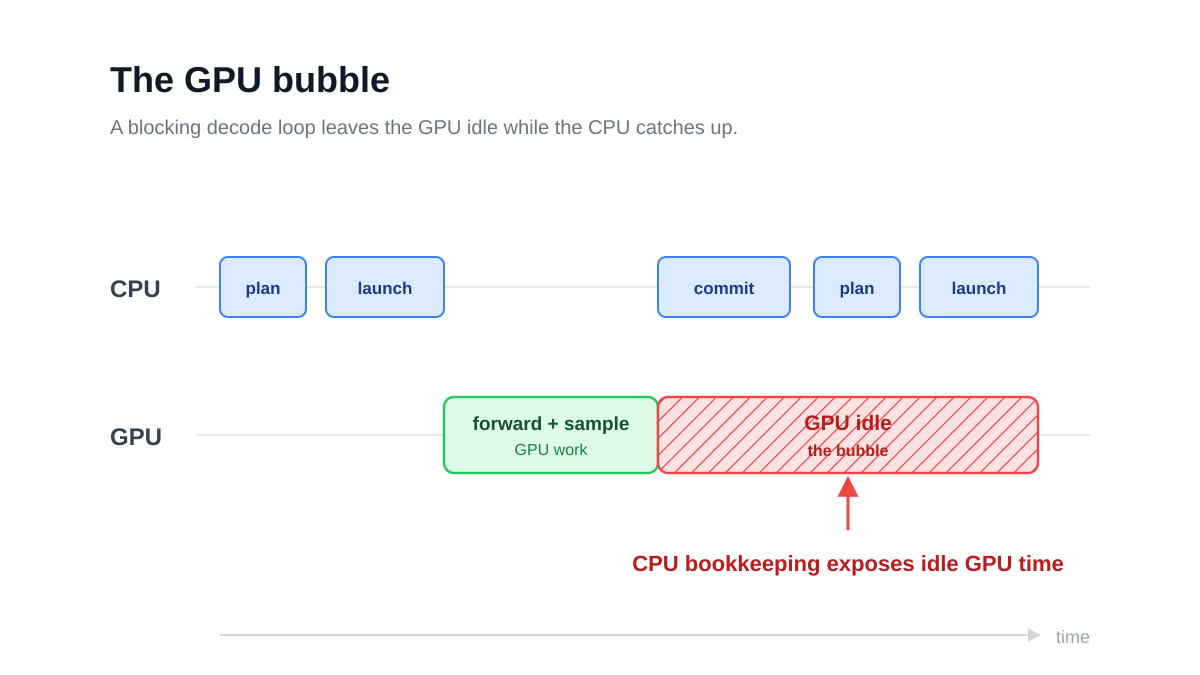
Инженерный пост Moondream начинается с контринтуитивного замера: во время генерации токенов GPU часто не делает ничего, и дело не в нехватке вычислений. Он ждёт, пока CPU закончит подготовку следующего токена. Этот простой авторы называют пузырём GPU (разрыв в конвейере вычислений, а не финансовый), и весь пост посвящён тому, как закрыть его внутри Photon, их движка инференса, чтобы выйти на почти реальное время в vision-language инференсе: примерно 33 мс на NVIDIA B200.
Наивный цикл декодирования строго последователен: CPU готовит шаг, запускает проход вперёд, ждёт его, сэмплирует токен, потом начинает заново. На каждой передаче между CPU и GPU кто-то из них простаивает.
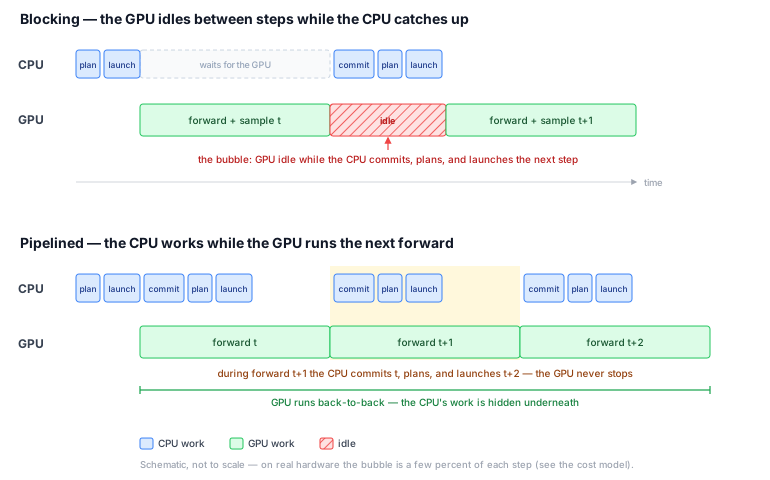
Верхняя часть таймлайна — это проблема: работа CPU и работа GPU идут по очереди. Нижняя показывает цель: пока GPU перемалывает шаг t+1, CPU уже фиксирует и сэмплирует шаг t. Никто не ждёт.
Два слота и копирование за спиной GPU
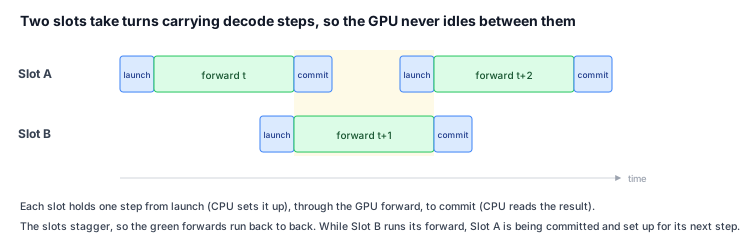
Чтобы наложить шаги, нужно куда-то положить входы и выходы шага t+1, не затирая данные шага t, которые CPU ещё читает. Photon использует пинг-понг-слоты: два чередующихся набора DecodeSlot, каждый хранит подготовку входов, вывод логитов, сэмплированные токены и учёт KV-кэша. Нечётные и чётные шаги используют разные слоты, поэтому GPU может писать в один, пока CPU читает другой.
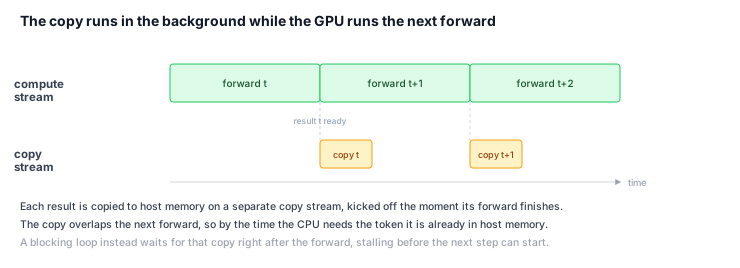
Второй приём — отложенное копирование. Чтение сэмплированного токена с GPU на CPU обычно принудительно вызывает синхронизацию. Photon выносит это копирование device-to-host в отдельный CUDA-поток, то есть в упорядоченную очередь, которую GPU разбирает по порядку и в которой работа из разных потоков может накладываться, так что копирование токена идёт, пока GPU уже занят следующим проходом.
Проход сейчас, сэмплинг потом — и последовательности, которые отказываются умирать
Планировщик выполняет каждый цикл как тик продвижения из трёх фаз: запустить проход для шага t+1, зафиксировать шаг t, затем завершить сэмплинг для t+1. Порядок важен: маски ограниченного декодирования зависят только от уже зафиксированного состояния, но не от результатов, которые ещё в полёте на GPU.
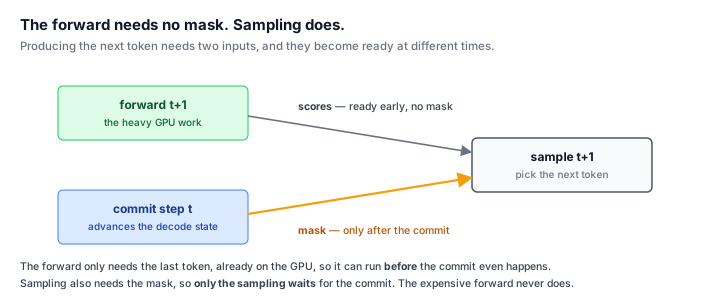
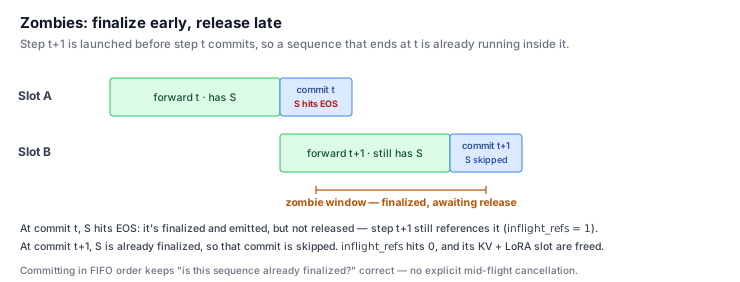
Этот конвейер порождает коварный класс багов. Последовательность может достичь токена конца последовательности на шаге t, когда она уже упакована в батч шага t+1 на GPU. Убить её сразу значило бы испортить батч в полёте. Photon оставляет её живой как зомби: флаг finalized помечает её завершённой после EOS или лимита длины, а счётчик inflight_refs отслеживает, сколько шагов в полёте всё ещё на неё ссылаются. Слот освобождается только когда счётчик обнуляется.
Цифры: выигрыш растёт вместе с GPU
Замеренная стоимость шага делится на проход вперёд и шаг сэмплинга. Чем быстрее GPU, тем сильнее фиксированные накладные расходы CPU доминируют в периоде:
| Железо | Конфигурация | Проход (мс) | Сэмплинг (мс) | Период (мс) |
|---|---|---|---|---|
| 3090 | 1 stream | 4.87 | 0.20 | 5.10 |
| 3090 | 8 streams | 6.66 | 0.27 | 6.97 |
| 3090 | 32 streams | 10.24 | 0.26 | 10.52 |
| B200 | 1 stream | 2.45 | 0.14 | 2.63 |
| B200 | 8 streams | 3.12 | 0.14 | 3.30 |
| B200 | 32 streams | 3.80 | 0.14 | 3.98 |
На фоне блокирующего базового варианта преимущество конвейерного цикла растёт от единиц процентов на 3090 до трети с лишним на B200:
| Железо | Конфигурация | Блокирующий (мс) | Конвейерный (мс) | Прогноз | Замер |
|---|---|---|---|---|---|
| 3090 | 1 stream | 5.44 | 5.10 | +5.7% | +6.5% |
| 3090 | 8 streams | 7.52 | 6.97 | +7.6% | +7.8% |
| 3090 | 32 streams | 11.74 | 10.52 | +11.1% | +11.6% |
| B200 | 1 stream | 3.11 | 2.63 | +17.2% | +17.6% |
| B200 | 8 streams | 4.04 | 3.30 | +22.2% | +21.9% |
| B200 | 32 streams | 5.55 | 3.98 | +39.1% | +35.4% |
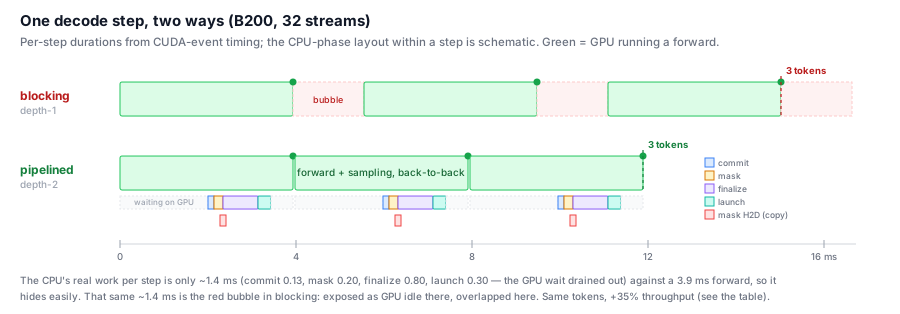
Замеренный таймлайн B200 подтверждает замысел: с конвейером GPU занят практически весь период, пузырь выдавлен.
Тред: отличный приём или артефакт маленькой модели?
Самый острый ответ пришёл от человека внутри дисциплины, который прочитал те же таблицы и вынес противоположный урок.
«блог хорош, но на нём куча отпечатков CODEX, и к тому же он очень привязан к размеру конкретной модели… проход вперёд в 2,4 мс — это крохи, а 9 млрд параметров помещаются на одном GPU. Большие модели ближе к 30–40 мс. Синхронизация CPU-GPU — это 1–2 мс… куда менее важно, чем, например, планирование вычислений/коммуникаций или оптимизация ядер». — инженер, работающий в этой области
Вот несущая оговорка: синхронизация CPU в 1–2 мс — это 35% от прохода в 2,4 мс и едва 5% от прохода в 40 мс. Именно поэтому колонка B200 выглядит настолько лучше колонки 3090. Чем больше модель, тем меньше доля этого пузыря в общем времени.
Бóльшая же часть треда зацепилась за заголовок. Бывший основатель ML-компании прямо описал путаницу:
«Это правда, но я никогда не слышал, чтобы это называли пузырём GPU… большинство слышит „GPU bubble“ и думает про какой-нибудь финансовый пузырь». — бывший основатель ML-компании и стартап-CTO
Другой читатель высказался резче, назвав такое имя намеренной наживкой на термин, который означает обвал рынка, и предложил вместо него GPU-CPU pipeline stall. Один комментатор предложил спасительную аналогию: кавитация винта на корабле, где скорость притока воды и форма лопасти решают, сколько эффективности стоят пузыри. Здесь GPU играет роль винта, а работа — приток воды.
Вывод для того, кто выкатывает инференс: приём окупается, когда проход вперёд достаточно мал, чтобы накладные расходы CPU были заметной его долей. На большой MoE-модели инсайдер из треда прав: сначала стоит потратить силы на наложение коммуникаций и на ядра.
Получайте такие разборы каждый день
Главные истории Hacker News — на email, в Telegram или RSS.
Доля труда в доходах США — минимум с войны. Вердикт ФРБ Нью-Йорка: ничего нового
Доля работников в национальном доходе — самая низкая со времён Второй мировой, на 1,6 пункта ниже, чем до пандемии. Федеральный резервный банк Нью-Йорка проверил, отличается ли нынешний спад от прежних, и ответил на собственный заголовок: нет.