Тег

RTX 3090

3 материалов

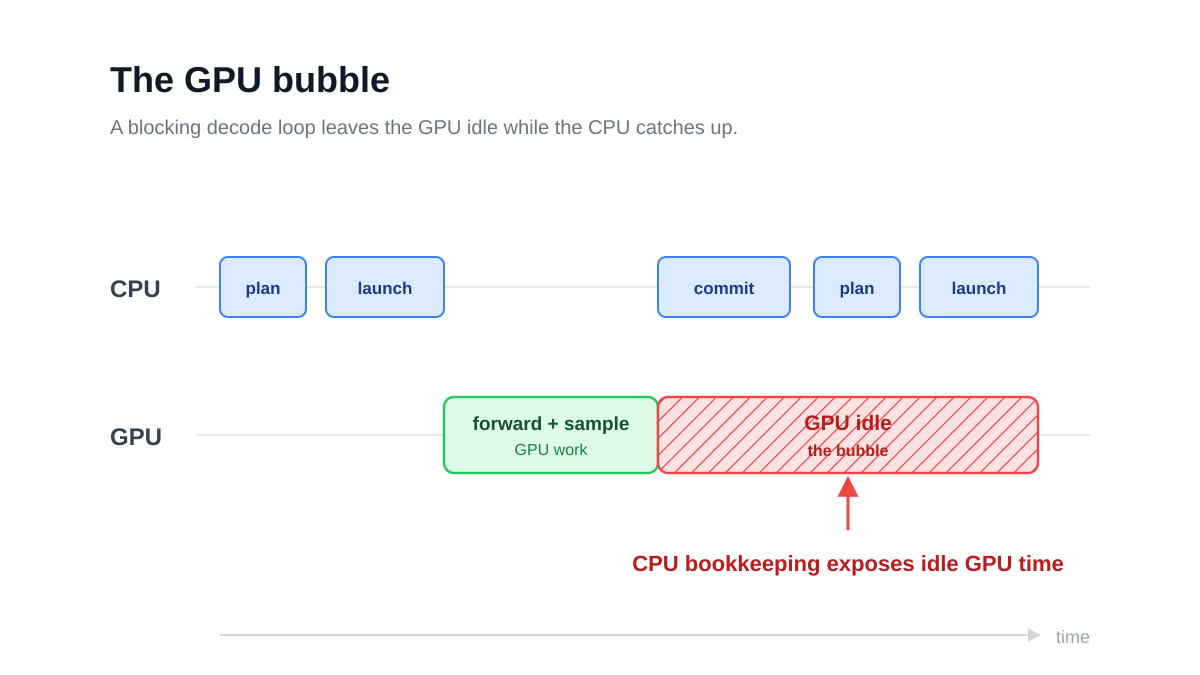
GPU ждал не вычислений, а CPU: Moondream отыграла 35% на B200 (moondream.ai)

При генерации токенов GPU часто простаивает не из-за нехватки вычислений, а потому что CPU ещё не закончил подготовку следующего токена. Moondream называет разрыв «пузырём GPU» и переписала движок Photon так, чтобы его спрятать: следующий проход вперёд накладывается на сэмплинг предыдущего.

Выигрыш растёт вместе с мощностью машины. На RTX 3090 приём даёт около 6,5%, а на B200, где синхронизация с CPU занимает бóльшую долю крошечного прохода в 2,4 мс, уже 35,4%. Инженер по инференсу возразил: цифра так велика лишь потому, что модель маленькая.
Не просто заголовок — разбор дискуссии

Главные треды HN: факты из обсуждений, разные стороны, голоса инсайдеров. Email, Telegram или RSS.

«Запусти GLM-5.2 локально» — мелким шрифтом: 512 ГБ ОЗУ и два 3090 (unsloth.ai)

Unsloth выпустил гайд по локальному запуску открытой GLM-5.2 — модели, которая, по ощущениям многих, закрывает разрыв с топовыми проприетарными.

Но владельцы железа в треде быстро приземлили эйфорию: «помещается в 256 ГБ» означает жёсткое квантование и черепашью скорость, а комфортный запуск — это 512 ГБ ОЗУ и пара видеокарт.

Главная мысль не про железо: открытая модель такого уровня показывает, что у OpenAI и Anthropic не магический ров, а лишь фора во времени.

80 токенов/сек на двух разных видеокартах — и спор, нужен ли ещё свой хостинг (imil.net)

Трюк — llama.cpp со спекулятивным декодированием и подобранным распределением тензоров по двум архитектурам, которые Nvidia никогда не задумывала вместе. Подвох, который замерил читатель: около 700 Вт под нагрузкой, хватает прогреть комнату.

Тред превратился в референдум. Один читатель платит в облаке около $3 за миллион токенов, причём без квантования, за ту же модель. Другой горюет, что культура «держи железо сам» «по сути мертва».

🚀Tech ★ 194 · 💬 67 · 14 июня · #ИИ#железо#open source#llama.cpp#Qwen#RTX 3090+1