Детектор ИИ-текста пометил 65% статей по CS, а потом и свой же пост
Исследователь прогнал 12 750 статей с arXiv через детектор ИИ-прозы и обнаружил, что детектор срабатывает на 65% свежих статей по информатике. Комментаторы тут же прогнали через тот же детектор его собственный пост в блоге и получили тот же вердикт: написано машиной.
Детектор пометил статью конференции 2015 года как 74% машинного текста, а диссертацию 2012 года как 40%, хотя обе написаны за годы до появления больших языковых моделей: так рассказал комментатор, прогнавший через инструмент собственные старые работы.
Автор инструмента признал в треде, что не может честно собрать контрольную группу человеческих текстов после 2023 года: любой доступный способ опирается на те же детекторы, которые он пытается обойти.
Проверка 12 750 статей с arXiv на запах ИИ
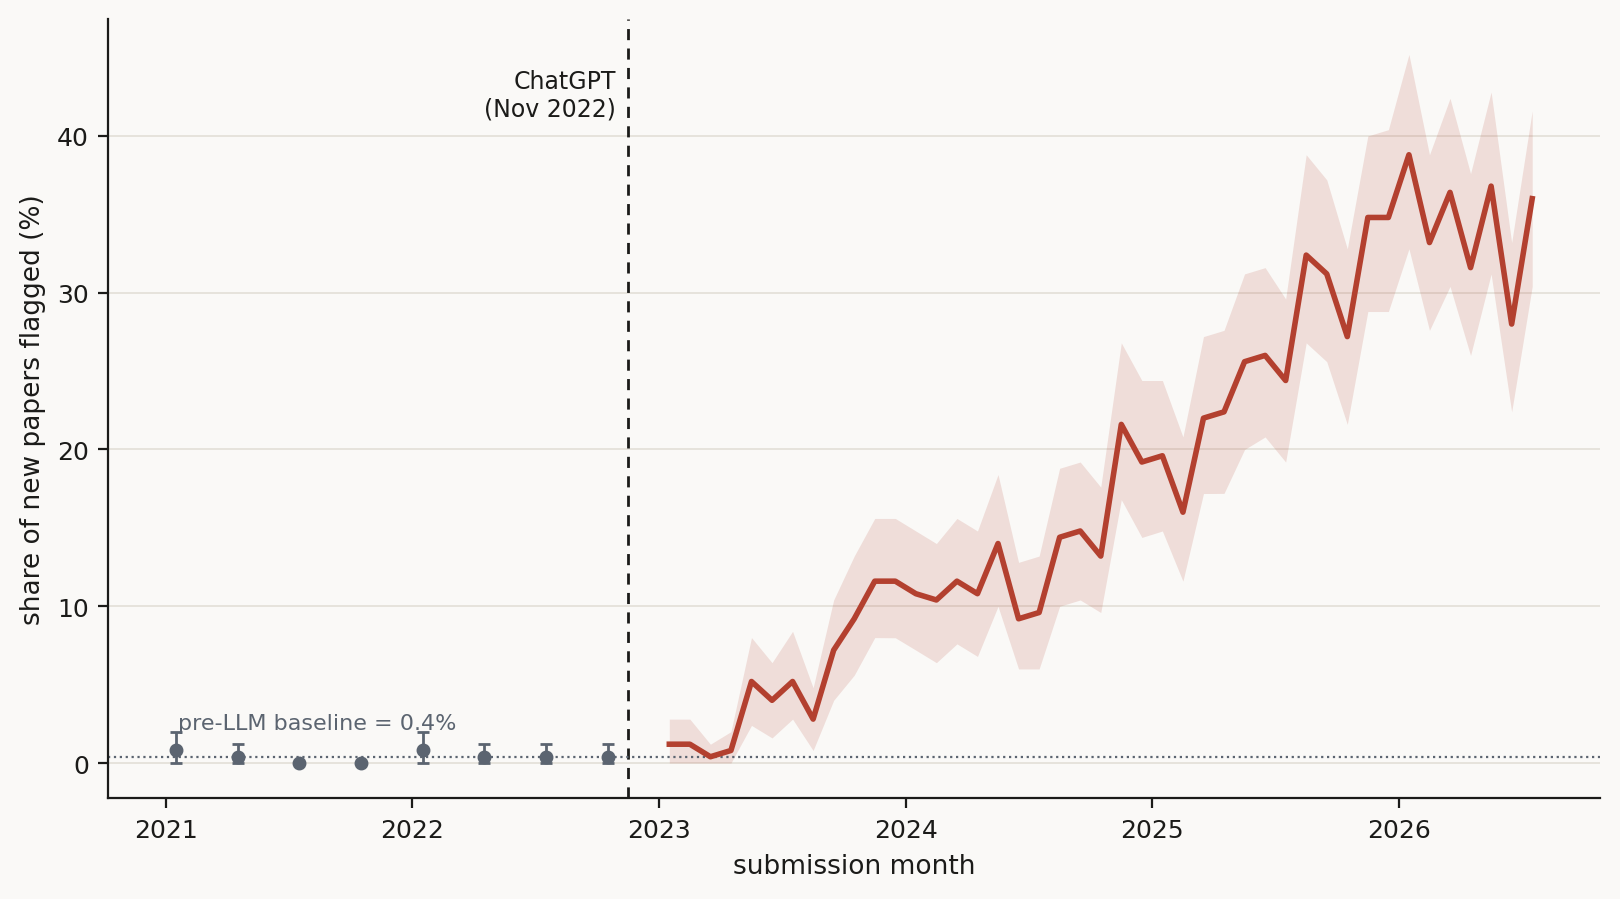
Автор исследования, выступающий под ником dopamine_daddy, собрал 12 750 статей с arXiv за период с января 2021 по июль 2026 года: примерно по 25 в месяц из десяти предметных групп, плюс отдельная контрольная выборка за восемь месяцев до появления ChatGPT. Только PDF первой версии, чтобы избежать загрязнения более поздними правками, и полный текст, а не аннотации, поскольку аннотации занижают сигнал детектора.
Детектор откалибровали по этой контрольной группе так, чтобы срабатывать ровно на 0,4% реально человеческих статей: намеренно консервативный порог, который держит долю ложных срабатываний низкой и, по словам автора, всё равно распознаёт 85% академического текста, написанного ИИ. Доля срабатываний держалась на уровне 0,4% в 2021-2022 годах, затем резко пошла вверх после запуска ChatGPT, достигла примерно 32% всех статей arXiv к середине 2026 года и пиково доходила почти до 39% ранее в этом году.
По областям доля неравномерна:
| Область | Помечено как машинный текст |
|---|---|
| Компьютерные науки | 65.0% |
| Количественная биология | 56.3% |
| Электротехника и системы | 51.3% |
| Экономика и финансы | 47.0% |
| Прикладная физика | 34.0% |
| Статистика | 31.3% |
| Физика конденсированного состояния | 24.0% |
| Физика высоких энергий | 14.0% |
| Астрофизика | 10.7% |
| Математика | 0.7% |
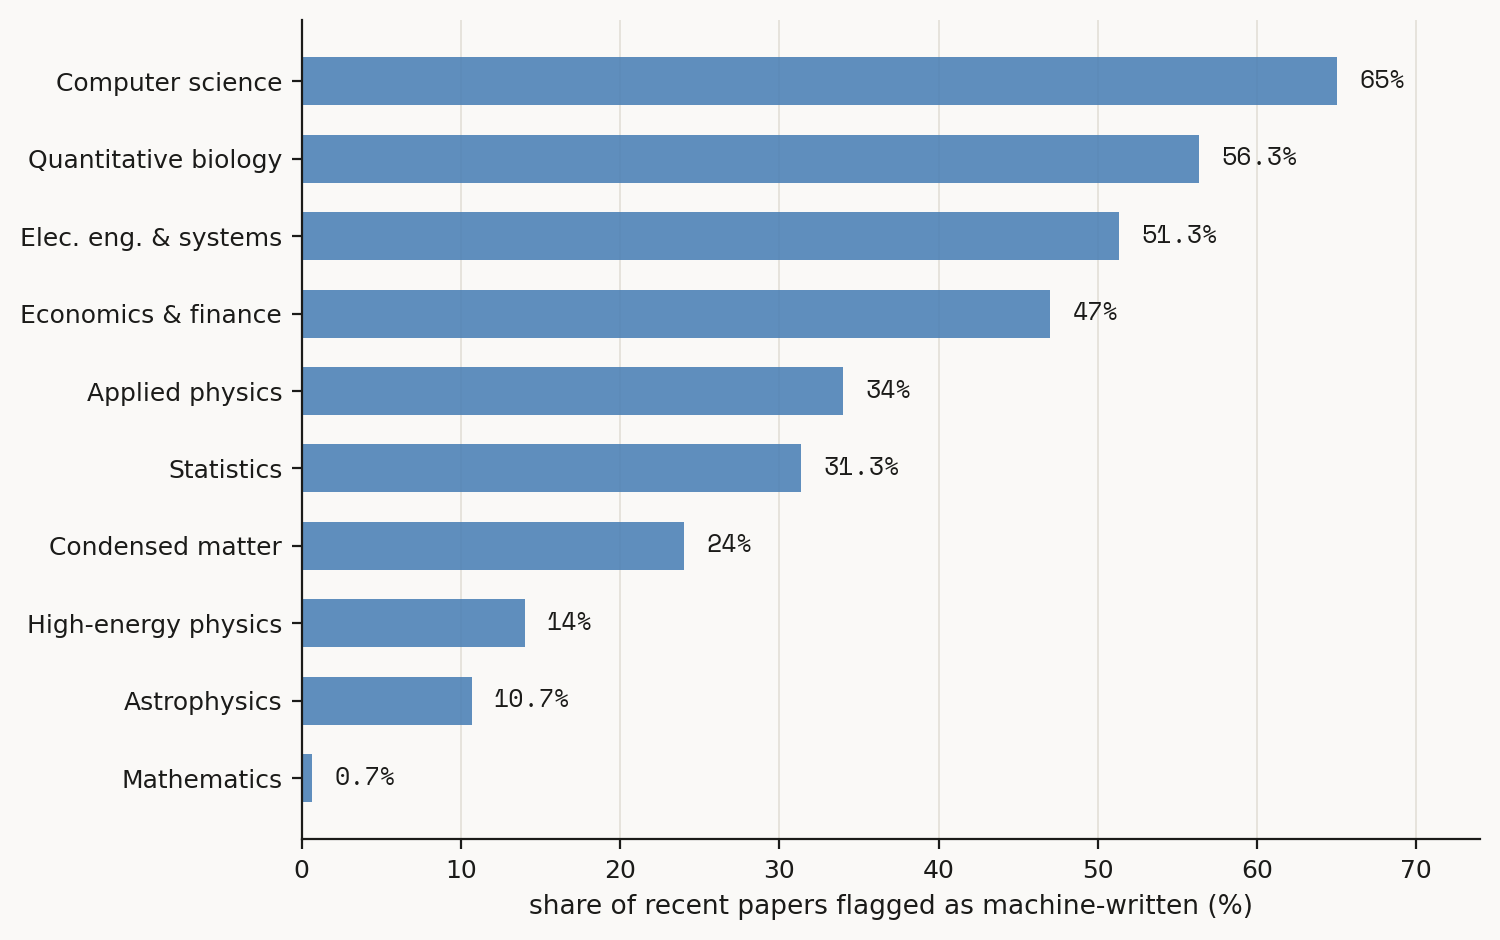
Собственные оговорки автора важны не меньше заголовочных цифр. Статьи по математике получают низкий балл отчасти потому, что после вычитания формул и цитат остаётся скупая проза, непохожая на научный английский, на котором обучали детектор, а не обязательно потому, что математики реже пользуются ИИ. Контрольная группа в 200 статей на область достаточно мала, чтобы данные по отдельным областям были приблизительными. И поскольку разные модели ИИ вызывают срабатывание детектора с разной частотой, автор описывает весь результат как нижнюю границу: «реальная доля — как минимум то, что мы измерили», а не точный подсчёт. Кроме того, детектор не умеет отличать статью, целиком сгенерированную ИИ, от статьи, которую человек написал сам, а затем прогнал через ИИ-редактуру.
Когда комментаторы направили детектор на саму статью
Самый смешной разворот в треде случился быстро: один читатель прогнал через собственный классификатор автора текст поста, объявляющего эти результаты.
«Мне одному кажется, или сама статья читается как сгенерированная ИИ?.. Я прогнал текст этой статьи через их же классификатор, и почти всё подсветилось красным.» — читатель
Второй комментатор не остановился на инструменте автора. Он сверил тот же текст с конкурирующим детектором:
«Конечно, так и есть! Способность человека распознавать паттерны — удивительная вещь, и, к сожалению, я видел столько ИИ-текста, что мозг подсветил это за три секунды после открытия страницы. Pangram согласен» — читатель, сверивший пост с Pangram, конкурирующим ИИ-детектором
Настоящие статьи многолетней давности, помеченные как «написанные машиной»
Более разрушительный для репутации детектора паттерн пришёл от людей, тестировавших его на текстах, которые появились за годы до LLM.
«Я загрузил свой доклад для семинара PyHPC, написанный в 2011 году, он получил 27% машинного текста. Ещё загрузил диссертацию 2012 года: вышло 40%, это чуть ниже порога в 42%… Ещё загрузил статью IEEE CLUSTERS 2015 года, она получила 74% машинного текста» — специалист по информатике, прогнавший через инструмент собственные десятилетние статьи
Другой комментатор получил похожий результат, тестируя не статьи, а ответы на Stack Overflow: доля машинного текста выросла до 96% после отключения удаления LaTeX-разметки, настройки, которая не должна была влиять на результат, если бы детектор оценивал стиль, а не артефакты форматирования.
Самое сильное контрдоказательство: массовая проверка конкурирующим детектором
Не все скептики опирались на горстку тестовых загрузок. Один комментатор ведёт агрегатор статей на базе arXiv и в рабочем порядке сверяет присланное с Pangram, конкурирующим детектором:
«Я очень скептично отношусь к этим результатам. У меня довольно крупный group-сайт со статьями поверх arXiv, и мы прогоняем их через pangram. Цифры там совсем не такие высокие. Часто вижу, что статьи помечают как ИИ-текст, потому что в них приведены примеры вывода LLM.» — человек, который ведёт сайт-агрегатор статей на базе arXiv
Методологическая претензия, на которую автор не смог ответить до конца
Самый острый технический вызов предположил, что детектор мог просто научиться распознавать лексику после 2022 года, а не собственно машинный стиль: термины вроде «large language model» почти не встречались в статьях до 2022 года, а теперь регулярно попадаются и в ИИ-, и в человеческом тексте. Автор исследования признал этот довод, а не стал его оспаривать:
«Вы подняли справедливый вопрос. Чисто по интуиции скажу: если это правда, то, вероятно, объясняет лишь малую долю реально помеченных статей. Я всё равно посмотрю, как это можно смягчить при обновлении детектора… Как вообще собрать чистый датасет после 2023 года? У меня нет очевидной идеи.» — автор исследования, dopamine_daddy
Что на самом деле поставлено на карту в рецензировании
Не все в треде считали ложные срабатывания главной историей. Комментатор с опытом NLP-исследований, который рецензирует статьи для конференций, поднял более острую проблему:
«Недавно я отклонил без рецензии статью, где буквально каждая ссылка во введении была галлюцинацией. Это значит, что вся связь между тем, что сделал автор, и существующими исследованиями была просто выдумана… Мы видим всё больше статей, написанных инструментами, которые, как известно, выдумывают факты, ссылки и даже целые работы.» — специалист по информатике с опытом NLP-исследований, рецензирующий конференции
Это и есть более сложная проблема под спором о детекторе: сработал классификатор на статье или нет, куда менее важный вопрос, чем существуют ли вообще её ссылки.
Получайте такие разборы каждый день
Главные истории Hacker News — на email, в Telegram или RSS.
Сельский боулинг заменил систему за $120 000 на чипы за $1 600
Кегельные автоматы в восьмидорожечном боулинге пользователя section33 — настоящая механическая антикварность 1950-х, и работают они исправно. Сломался маленький датчик фола: фирменную замену для этой единственной детали оценили в $750, и это отправило нового владельца боулинга в кроличью нору ESP32.