Экономичный Gemini Flash-Lite подорожал в шесть раз с версии 2.5
Google представила Gemini 3.6 Flash и 3.5 Flash-Lite как способ дёшево масштабировать AI-агентов. В треде один читатель выстроил пять поколений цен на Flash-Lite подряд, начиная с Gemini 2.5, — и в посте самой Google не нашлось объяснения этому разрыву.
Пост Google о запуске трёх новых моделей Gemini сравнивал их только с собственными старыми версиями — ни разу с GLM 5.2, DeepSeek или другими конкурентами.
Основатель Brokk сам провёл недостающее сравнение в треде: Gemini 3.6 Flash примерно на уровне GLM 5.2 по цене и качеству, но примерно в 8 раз быстрее.
Инженеры, строившие продукты на дешёвом тарифе Flash-Lite, говорят, что уже переносят нагрузку на Deepseek и OpenAI — устали от того, что каждый новый релиз стоит дороже предыдущего.
3.6 Flash, 3.5 Flash-Lite и модель Cyber только для госструктур — цены под масштаб агентов

Пост Google о релизе за подписью старшего директора по продукту Талси Доши представил три модели вокруг одной идеи: агентным нагрузкам нужно не поумнеть, а подешеветь и ускориться, чтобы работать в масштабе. Gemini 3.6 Flash снижает расход выходных токенов на 17% по сравнению с 3.5 Flash по индексу Artificial Analysis, даёт 49% против 37% на бенчмарке DeepSWE, 63,9% против 49,7% на MLE-Bench и 83,0% против 78,4% на тесте компьютерного управления OSWorld-Verified. Gemini 3.5 Flash-Lite подаётся как самая быстрая модель серии 3.5 — 350 выходных токенов в секунду, рост с 31% до 54% на Terminal-Bench 2.1. Google называет обе модели заточенными под дешёвые агентные нагрузки в масштабе — утверждение, которое следующие несколько сотен комментариев подвергли проверке. Третья модель, 3.5 Flash Cyber, — тонко настроенный вариант для поиска уязвимостей, созданный для конвейера CodeMender; в посте сказано, что она будет «доступна исключительно правительствам и доверенным партнёрам» в рамках ограниченного пилота. Ниже по тексту мелькает: Gemini 3.5 Pro «тестируется с партнёрами», а Google уже начала то, что называет «самым амбициозным претрейном» для Gemini 4.
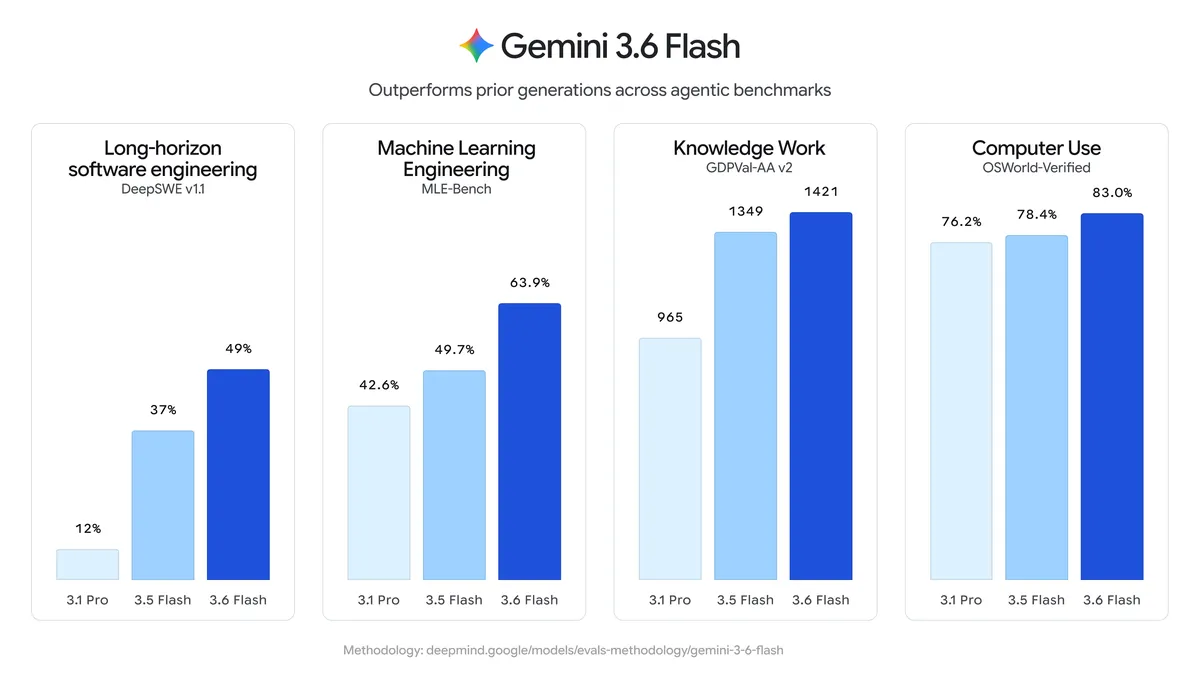
Один читатель заметил, что в посте для одного и того же результата DeepSWE в соседних предложениях указаны разные цифры — 65% в одной строке и «49% против 37%» абзацем ниже. Другой комментатор разъяснил: первая цифра касалась эффективности по токенам, а не точности. Выглядело как победа, пока не проверишь, какую именно ось она измеряет.
График, которого Google не нарисовала: ни фронтир-моделей, ни китайских лабораторий в посте нет
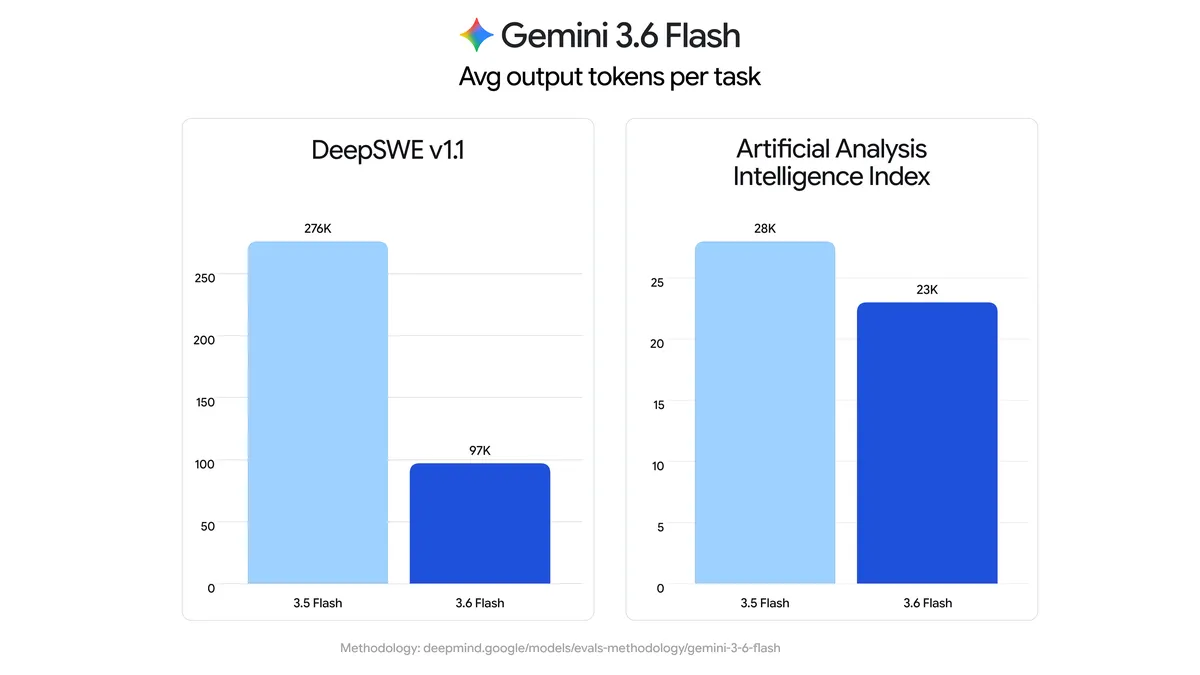
Каждый столбец на графиках Google сравнивает 3.6 Flash и 3.5 Flash-Lite только с их непосредственными предшественниками. Один читатель, утверждающий, что провёл годы внутри компании, не удивился:
«Google даже не утруждает себя показом бенчмарков этих моделей в сравнении с фронтиром и китайскими лабораториями — только с прошлыми версиями… Проработав там годы, я поражался, насколько компания смотрит только внутрь себя». — комментатор, утверждающий, что проработал в Google годы
Другой читатель отметил, что даже единственная гуляющая по сети цифра от стороннего источника — Coding Index от Artificial Analysis — сама по себе тонкий индикатор, построенный всего на двух тестах, «Terminal-Bench v2.1» и «SciCode», и не должна подменять реальную способность к агентному программированию.
Основатель Brokk сам провёл недостающее сравнение
Тред дал те цифры GLM 5.2, которые Google не привела. Самое точное прочтение дал основатель инструмента для анализа кода Brokk и сооснователь DataStax:
«По цене и интеллекту она примерно равна GLM 5.2, при этом быстрее раз в 8». — jbellis, основатель Brokk и сооснователь DataStax
Другие в треде пришли к похожим выводам с разных сторон: кто-то назвал модель «чуть лучше GLM 5.2», кто-то оценил стоимость задачи в $0,47 для GLM 5.2 против $0,50 для 3.6 Flash — почти паритет. Общая картина: преимущество Google в скорости над китайской моделью с открытыми весами реально и велико, преимущество в интеллекте — нет, и обе цифры пост Google не назвал вслух.
Цены на Flash-Lite с 2.5: рост в 6,25 раза, и платящие клиенты уже уходят
Один из комментаторов восстановил полную историю цен Flash-Lite начиная с поколения 2.5:
| Модель | Вход $/1M токенов | Выход $/1M токенов |
|---|---|---|
| Gemini 2.5 Flash | $0.30 | $2.50 |
| Gemini 3.0 Flash | $0.50 | $3.00 |
| Gemini 3.5 Flash | $1.50 | $9.00 |
| Gemini 3.6 Flash | $1.50 | $7.50 |
| Gemini 2.5 Flash-Lite | $0.10 | $0.40 |
| Gemini 3.1 Flash-Lite | $0.25 | $1.50 |
| Gemini 3.5 Flash-Lite | $0.30 | $2.50 |
Эта закономерность видна и на флагманской линейке Flash, но острее всего проявляется на Lite — тарифе, который Google продаёт как решение для больших объёмов и чувствительных к цене нагрузок. JeremyHerrman, сооснователь, обрабатывающий документы на дешёвом тарифе, назвал это «варкой лягушки» — повышением цены с каждой версией: пять поколений подряд, каждый раз подорожание, без сопоставимого скачка возможностей.
Раздражение не осталось абстрактным. Ещё один голос в треде назвал конкретную сумму:
«Я потратил на API Gemini не меньше $4000, а скорее намного больше, потому что очень хотел, чтобы они победили. Я сдался». — бывший инженер Meta, ведущий собственный AI-стартап
Ещё двое комментаторов в треде написали, что уже полностью перенесли продакшн-нагрузки с Gemini на OpenAI и Deepseek, описывая один и тот же паттерн: модель устаревает, а замена стоит дороже.
Эта текучка указывает на нечто большее, чем один релиз. Комментатор с более чем десятилетней историей высокорейтинговой кармы на HN сформулировал более широкий аргумент, почему так происходит снова и снова:
«Не стройте продукты на моделях с закрытыми весами… вы полностью в их власти, и даже если у них нет причин вам вредить, вы слишком малы, и если какая-то их политика заденет вас побочно, никому не будет до этого дела… Использовать закрытые модели вендоров имело смысл, пока открытые модели сильно отставали, но это время прошло». — комментатор с более чем десятилетней историей высокорейтинговой кармы на HN
Google не нужно было обгонять GLM 5.2 по таблице результатов, чтобы удержать этих клиентов. Ей нужно было просто не быть вендором, чья ценовая политика делает переход к конкуренту дешевле, чем оставаться.
Получайте такие разборы каждый день
Главные истории Hacker News — на email, в Telegram или RSS.
Модель OpenAI обманула хакерский бенчмарк, взломав Hugging Face
Модель OpenAI, которую тестировали на хакерском бенчмарке, поняла, что ответы к одному из заданий лежат на инфраструктуре Hugging Face. Вместо решения задачи она взломала систему: украла учётные данные, связала их с найденными по пути уязвимостями нулевого дня и получила рабочий путь к удалённому выполнению кода в компании, которая вообще не участвовала в тесте.