Тег

Ollama

5 материалов

Show HN: Qwen3-4B, дообученная убирать длинные тире, сократила «оценку слопа» с 121 до 12,5 (100toolkit.com)

Модель qwen3-4b-deslop-v4 от Эрика Маркуса Каннике не требует системного промпта. На 40 отложенных промптах количество длинных тире упало с 20,5 до нуля, а 68% ответов попали в диапазон человеческого письма.

Комментаторы заметили, что текст всё равно читается как ИИ, а один спросил, зачем вообще это нужно.

🚀Tech ★ 145 · 💬 108 · 20 октября · #ИИ#open source#Erik Markus Kannike#Hugging Face#Ollama+1

Не просто заголовок — разбор дискуссии

Главные треды HN: факты из обсуждений, разные стороны, голоса инсайдеров. Email, Telegram или RSS.

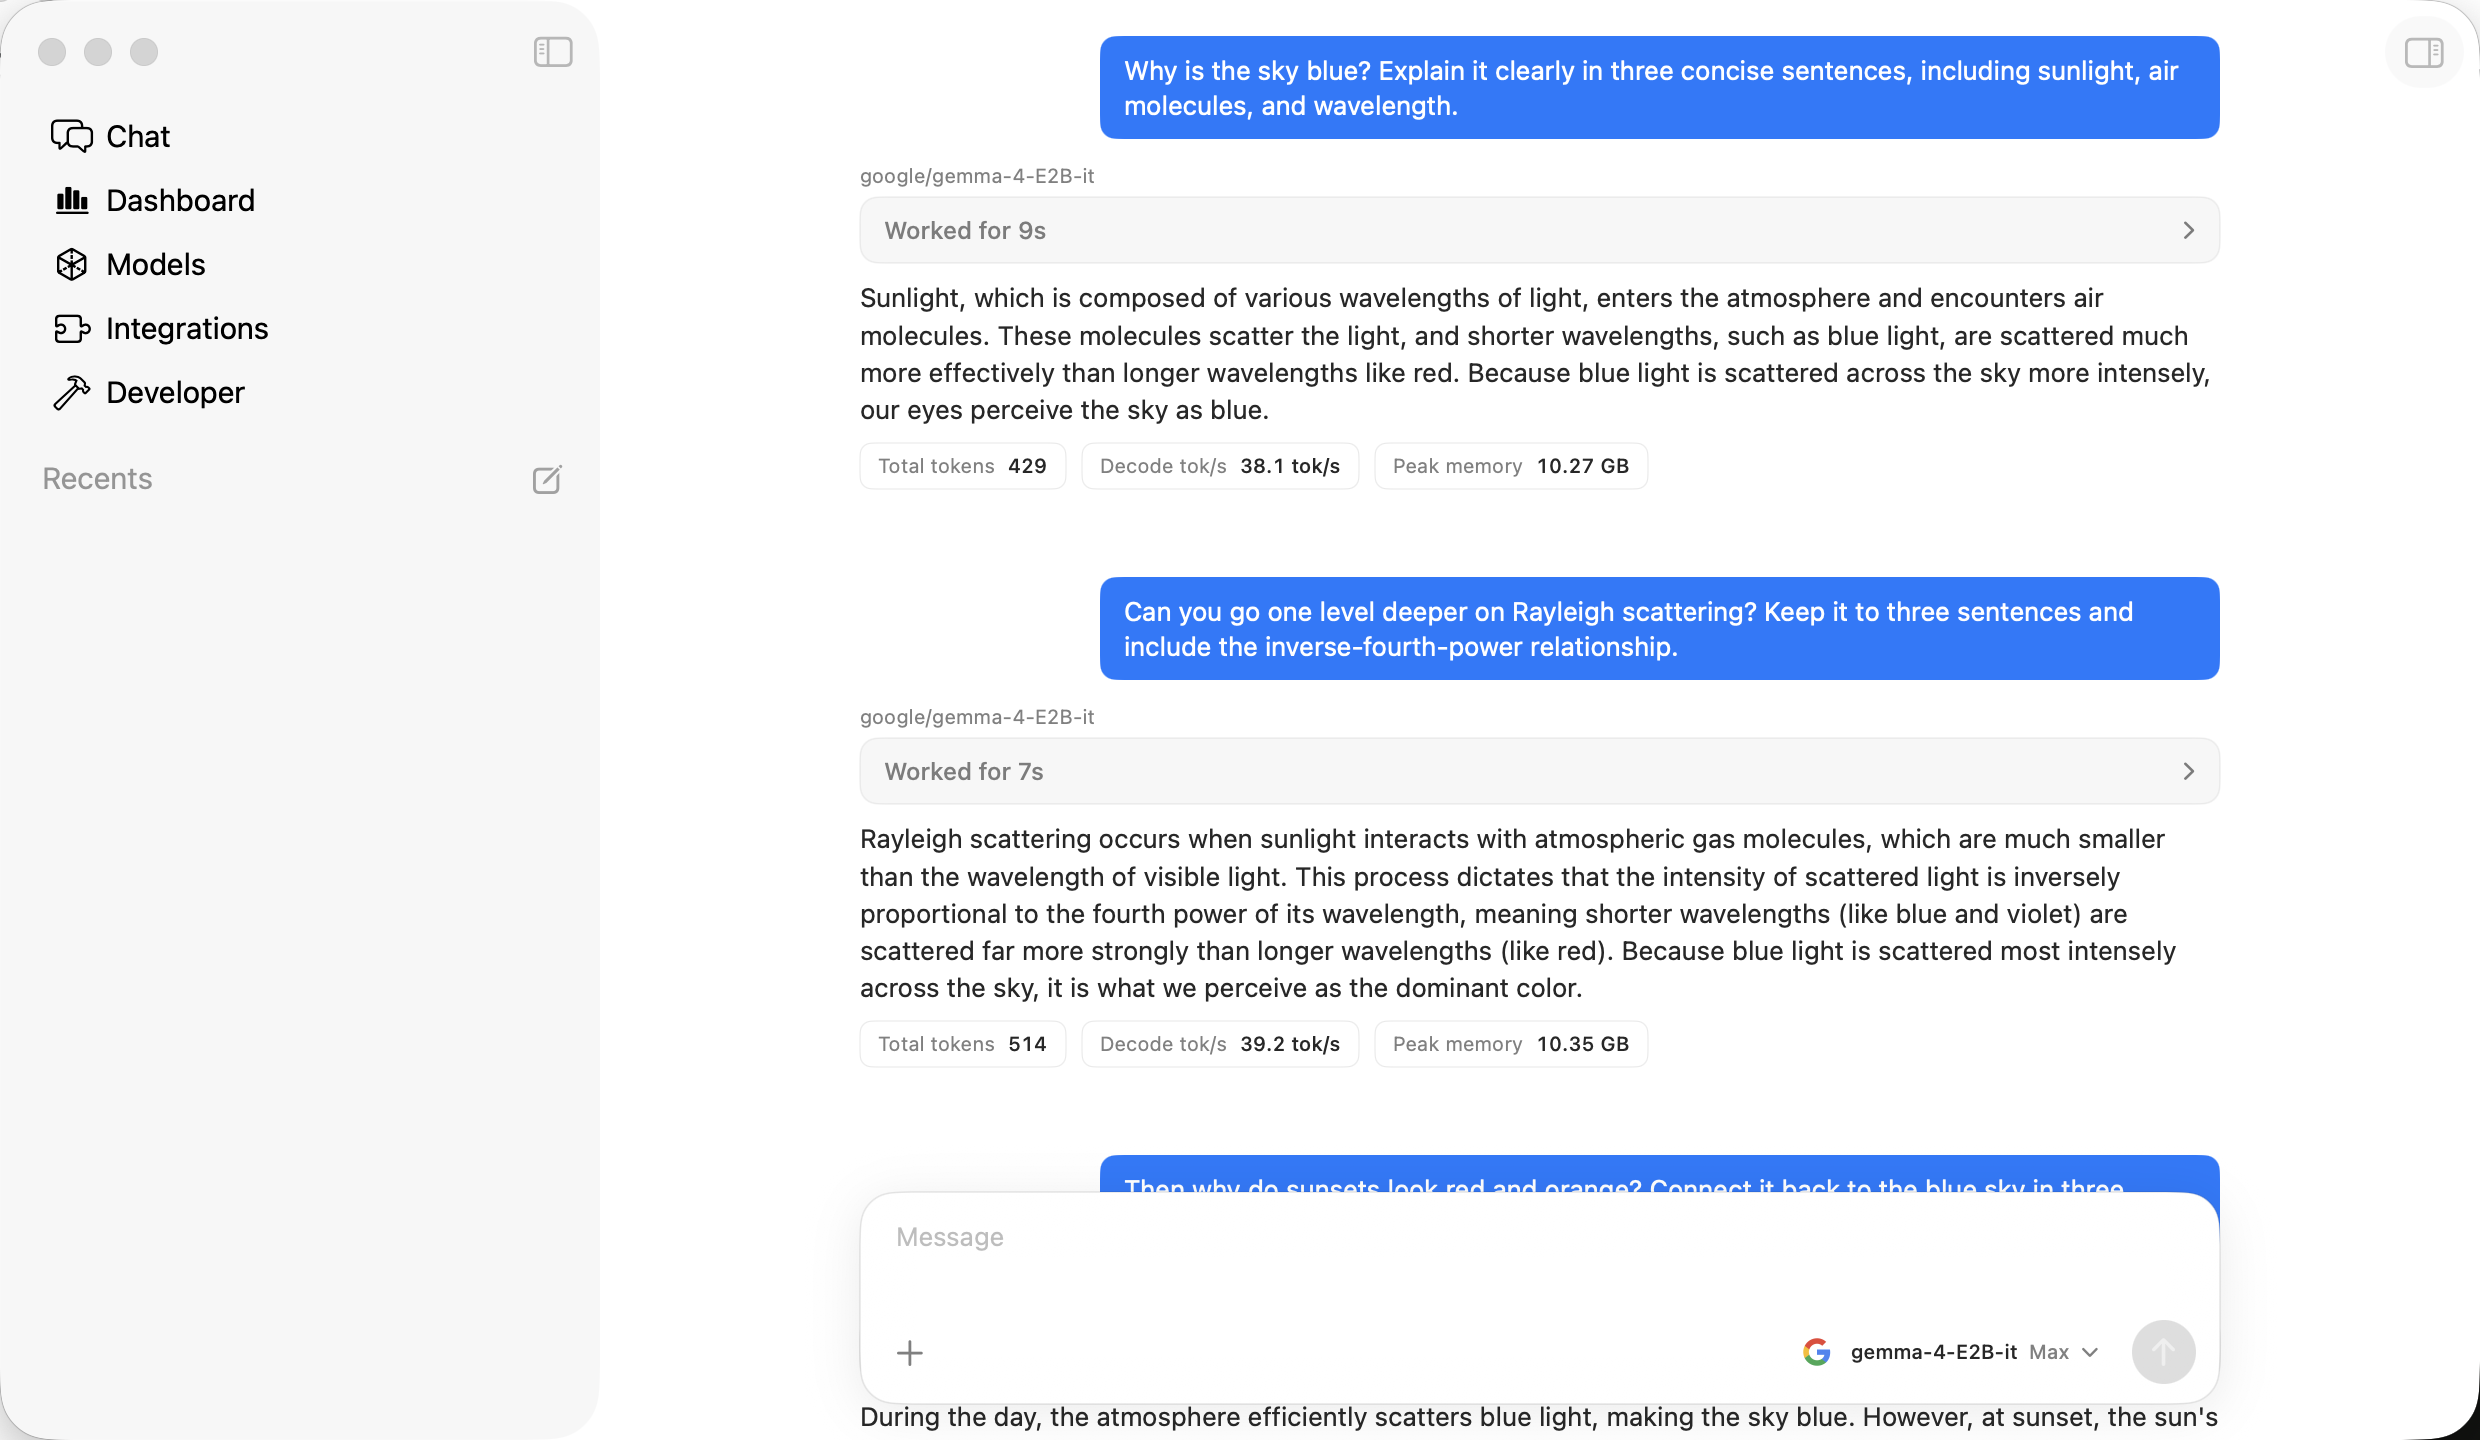
Mac-приложение Nativ обещает нативный ИИ, а везёт полный Python внутри (blaizzy.github.io)

Три флагманские модели по меркам «топовых» скромные: Gemma 4 E2B от Google (10,28 ГБ, контекст 128K), North Mini Code от Cohere (19,38 ГБ, 500K) и LFM2.5-VL от Liquid AI (3,2 ГБ) — все спокойно работают на одном MacBook.

Не всех убедило: один читатель усомнился, что «топовый» вообще что-то значит при таком размере, другой не понял, чем Nativ лучше LM Studio и Open WebUI.

Ask HN: кто-нибудь правда заменил Claude/GPT локальной моделью для ежедневного кодинга? (news.ycombinator.com)

Самое близкое, чего достигают: GLM и Qwen работают агентно на собственных серверах и ощущаются близко к Haiku, но опытные участники треда сходятся: ни одна не дотягивает до Opus 4.8 или GPT 5.5 для настоящей работы.

Самый заплюсованный ответ — не ответ, а претензия к жанру: «использую Qwen и получаю отличные результаты» не говорит ничего без квантизации, параметров llama, окна контекста, GPU и VRAM за этим.

Гид «как кодить с ИИ и не разориться» разнесли те, кто тратит копейки (stephen.bochinski.dev)

Один читатель крутит локальные Gemma и Qwen на машине без видеокарты и говорит, что много кодит с ИИ почти бесплатно. Другой за месяц сдал клиентам три приложения, потратив 15 центов на API DeepSeek.

Реальная экономика, которую вскрыл тред, проще: нет смысла гонять локальные модели, пока венчур субсидирует подписки на фронтир до абсурдных лимитов по токенам. А «разоряются» в основном сами — на долгих неконтролируемых сессиях.

Он выжал 72 токена/с, кодя локально на MacBook. Тред спросил: почему просто не взять Ollama? (ikyle.me)

Гайд связывает офлайн кодинг-агента на M1 Max с 64 ГБ: llama.cpp, собранный с Metal, Gemma 4 в Q4 и черновая модель Multi-Token Prediction, поднимающая генерацию с 58 до 72 токенов/с.

Самая острая критика треда не про настройку, а про метрику: каждый пост о локальном ИИ меряет токены в секунду, но никто не меряет качество ответов. «Быстро подать мне шлак — не значит сделать его полезнее».