GLM-5.2 возглавила open-weights с 51 баллом по Intelligence Index — и сжигает на это 43 тыс. токенов
GLM-5.2 от Z.ai набрала 51 балл по индексу Artificial Analysis — лучший результат среди open-weights и в одном бенчмарке отставание от GPT-5.5 на балл. Платит она за это 43 тыс. токенов на задачу: один тестировщик смотрел, как она рассуждает 15 минут, прежде чем написать первую строку кода.
GLM-5.2 от Z.ai (744B всего, 40B активных) — теперь топовая open-weights-модель на Artificial Analysis с 51 баллом, впереди DeepSeek V4 Pro и Kimi K2.6, а в одном бенчмарке она набрала 1524 против 1514 у GPT-5.5.
Подвох — в многословии: 43 тыс. токенов на задачу, из них 37 тыс. на рассуждения. Один тестировщик засёк 15 минут и 45 тыс. токенов до появления первого файла. Главный научный сотрудник Sibylline всё равно рекомендует её: связка GLM для письма плюс дешёвая подписка GPT для ревью даёт результат уровня почти Opus за долю цены.
744-миллиардная открытая модель отстаёт от GPT-5.5 на балл
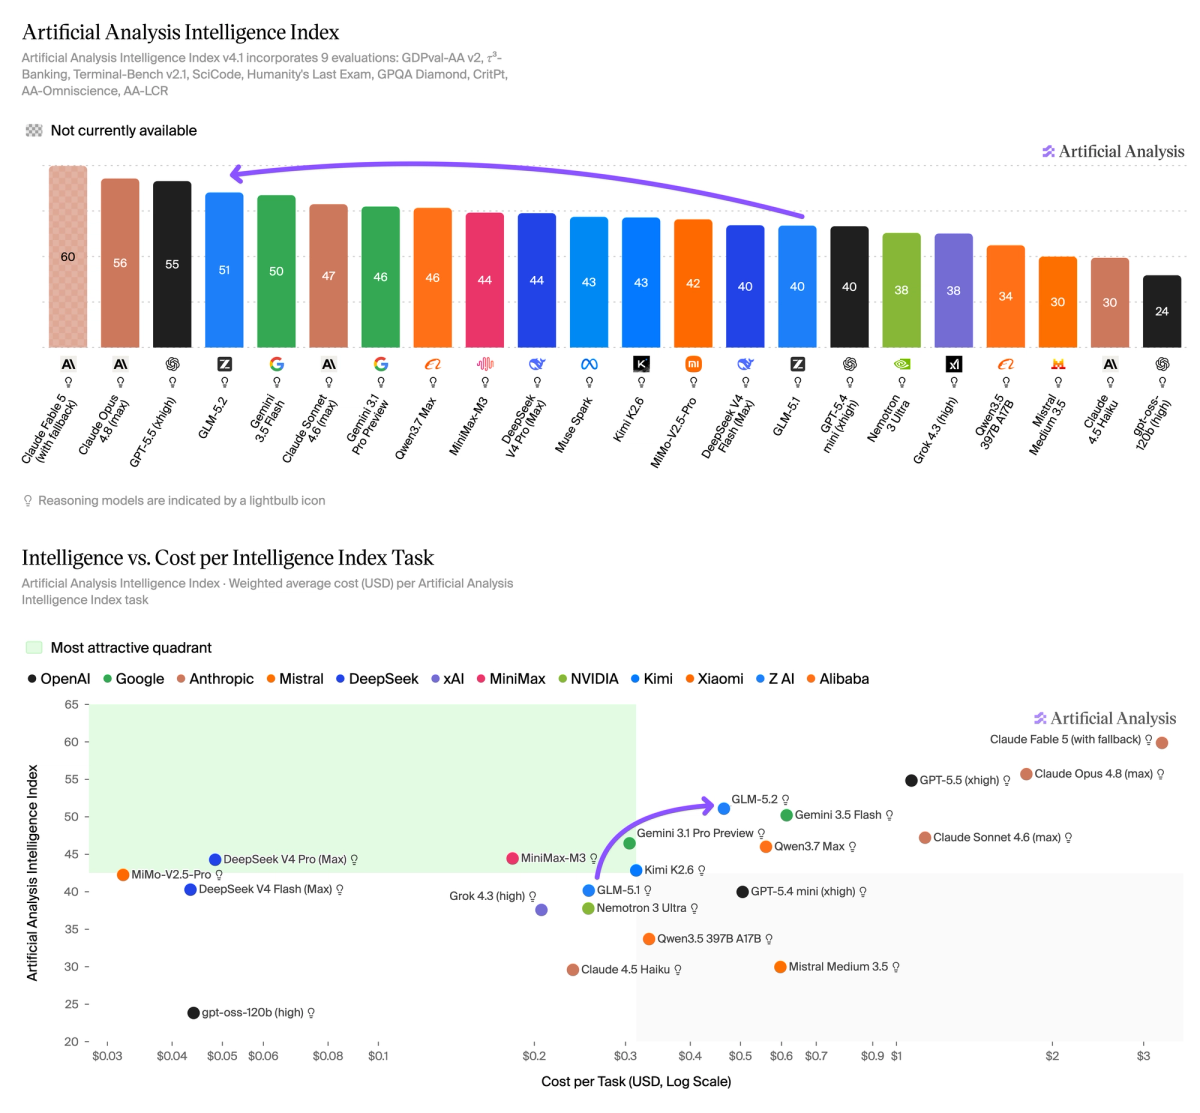
Отчёт Artificial Analysis говорит прямо: GLM-5.2 от Z.ai — самая сильная open-weights-модель из тех, что они измеряли. Она набирает 51 балл по Intelligence Index v4.1, заметно впереди следующих открытых моделей — MiniMax-M3 и DeepSeek V4 Pro с 44, Kimi K2.6 с 43. Архитектура — mixture-of-experts на 744B параметров, из которых активны лишь 40B, а контекстное окно выросло с 200K до 1M токенов.
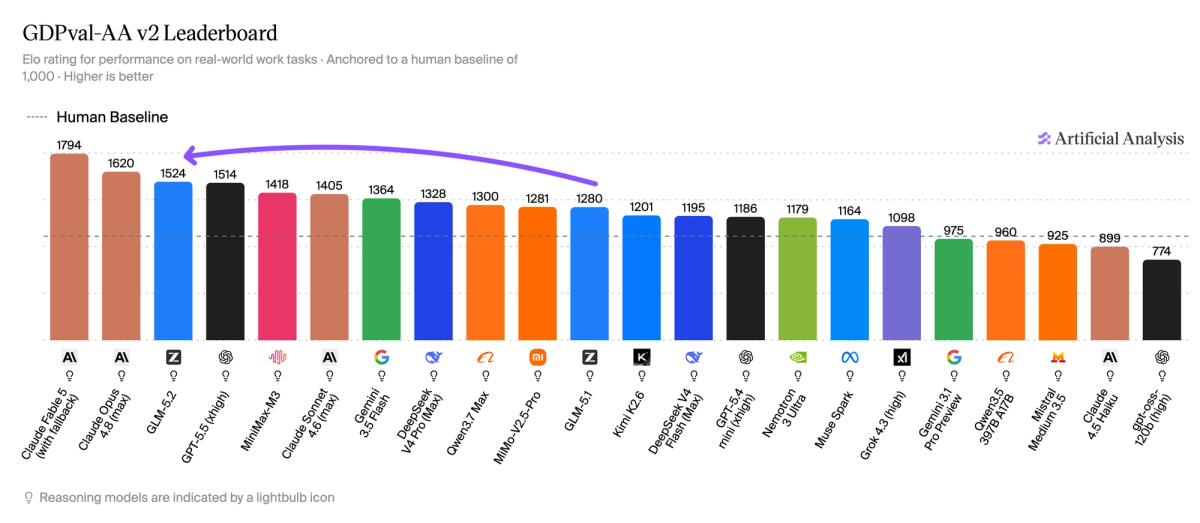
Ещё заметнее цифра в бенчмарке GDPval-AA v2, где GLM-5.2 показала 1524 против 1514 у GPT-5.5 — открытая модель чуть обошла проприетарную frontier-модель. Прирост в научном рассуждении большой: +16 баллов на CritPt, +16 на TerminalBench v2.1 до 78%.
Сноска — в счёте за токены
Сама Artificial Analysis отмечает цену: GLM-5.2 сидит «вне самого привлекательного квадранта на графике „интеллект против выходных токенов“». Она тратит 43 тыс. выходных токенов на задачу, 37 тыс. из них — чистое рассуждение. Интеллект почти frontier-уровня; эффективность — нет.
Эта абстрактная точка на графике превратилась в конкретную жалобу в треде. Один тестировщик прогнал свою стандартную пробу — небольшую библиотеку для оценки математики на Nim, 400–600 строк — и наблюдал, как модель кружит в собственных мыслях:
«GLM 5.2 (xhigh…) потратила больше 15 минут (!) на рассуждения, около 45 тыс. токенов, прежде чем наконец написала первый файл… GPT 5.5 xhigh тратит в среднем 16 тыс. токенов на всё». — разработчик, тестирующий модели на фиксированной задаче по Nim
Математика стоимости задачи тоже вызвала прищур. Отчёт ставит GLM-5.2 на границу Парето при ~$0,46 за задачу, но один читатель выложил цифры рядом: GLM-5.1 — $0,25, Kimi K2.6 — $0,31, MiniMax-M3 — $0,18, а DeepSeek V4 Pro всего $0,05, так что формулировка «самая дешёвая на своём уровне интеллекта» сильно натянута.
Взгляд изнутри: достаточно хороша, чтобы поменять стек подписок
Самый авторитетный голос в треде провёл с ней целый день.
«Она вполне способная, хотя немного многословна (я видел, как она пересматривает решения по 3–4 раза в цепочках размышлений…), и не так хороша, как GPT5.5, в проработке сложных абстрактных требований». — CuriouslyC, главный научный сотрудник и CEO Sibylline Software
Его практический вывод и есть главная новость для большинства: подписка Z.AI плюс OpenAI за $20 в месяц закрывает «всех, кроме самых упоротых мульти-оркестраторов и преданных фанатов Claude» — GLM пишет, GPT ревьюит и отлаживает, и это выходит «минимально хуже, чем делать всё в GPT на плане за $200 в месяц».
Другие были в большем восторге. Один указал на голое соотношение цены и качества: провайдеры предлагают качество почти «Opus 4.7» при безлимитных токенах за $50 в месяц, с ценами на API заметно ниже официальных тарифов Z.AI — «огромный удар по Anthropic/OpenAI/Google и колоссальная победа для остального мира». Финтех-инженер назвал её «настоящим шагом вперёд… очень эпистемически осторожной в рассуждениях».
Возражения: пропускная способность, модальность и «вы её неправильно держите»
Убедились не все. Регулярная практическая претензия — Z.ai не справляется со спросом:
«У Ziphu реально очень туго с мощностями — все жалуются на таймауты или жуткую медлительность… из-за проблем с мощностями моим основным провайдером в последнее время стал DeepSeek». — подписчик плана Lite, не получающий прямой доступ к модели
Замечание о недостающей модальности указало, что ни DeepSeek, ни GLM не принимают изображения на вход, а это ограничивает их на интерфейсах, скриншотах и фото. А самый резкий скептик прошёлся по самому хайпу вокруг бенчмарков: на собственном графике coding-агентов у Artificial Analysis GLM-5.1 на high стоила вдвое дороже и была вдвое тупее, чем GPT-5.5 на medium — «реально заставляет задуматься, насколько легитимен весь этот интернет-шум вокруг открытых моделей».
Главное — часы до локальных моделей
Если убрать драму лидербордов, в треде всплывает один вопрос: как скоро бизнес сможет гонять что-то настолько хорошее на своём железе? Модель уровня почти Opus, работающая локально «в ближайшие пару месяцев», больше не читается как фантастика, и несколько человек взвешивают, не купить ли GPU ради приватности и контроля вместо аренды frontier-API. GLM-5.2 не бьёт GPT-5.5 в лоб и платит за интеллект токенами. Но фраза «топовая open-weights-модель, на балл позади frontier, запускается на своих машинах» год назад просто не складывалась.
Получайте такие разборы каждый день
Главные истории Hacker News — на email, в Telegram или RSS.
60% американских потребителей отталкивает слово «ИИ» в рекламе, а 61% не назовёт ни одного бренда, делающего это хорошо
WordPress VIP опросил 1 200 потребителей в США: 60% воспринимают «ИИ» в подаче бренда как минус, 74% считают, что веб стал менее человечным, чем десять лет назад, а 61% не может назвать ни одного бренда, который использует ИИ эффективно.