Тег

llama.cpp

5 материалов

PS5LM превращает взломанную PlayStation 5 в LLM-сервер с API, совместимым с OpenAI (github.com)

На PS5 Slim README сообщает 207 токенов в секунду для модели Qwen на 0,8 млрд параметров, 55 — для 9 млрд и около 20 — для 27 млрд при контексте 64k. Консоль отдаёт модели 11,4 ГБ общей памяти.

Не просто заголовок — разбор дискуссии

Главные треды HN: факты из обсуждений, разные стороны, голоса инсайдеров. Email, Telegram или RSS.

Модель на 27B хорошо кодит локально — на ноутбуке за $6 699, что жжёт пальцы (quesma.com)

Пост сталкивает плотную 27B с более быстрым MoE-вариантом на 35B и выбирает качество, а не скорость: «лучше сгенерирую втрое меньше кода, но качественнее». Модель прогнали через сборку гекс-сапёра и лендинг свечной лавки.

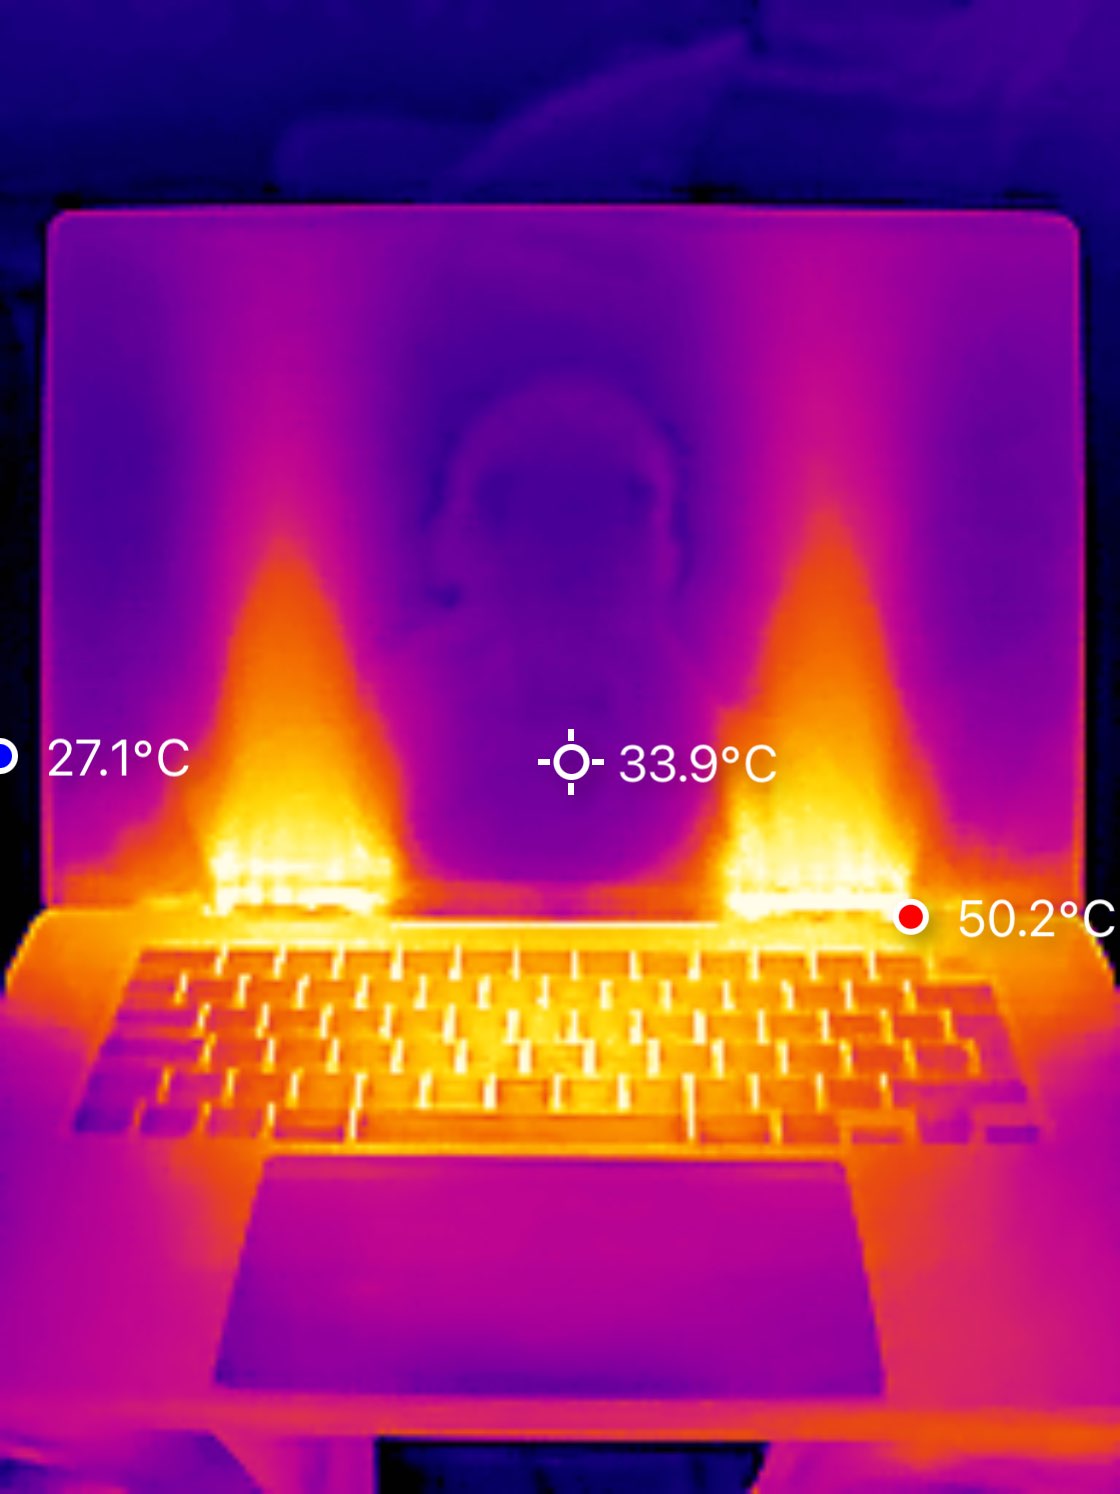
Основатель, у которого ровно такая машина, резко возразил: запусти на самом ноутбуке тяжёлую задачу — пальцы жжёт, вентиляторы воют. Его решение: поставить Mac Mini в подвал и ходить к нему через Tailscale, втрое дешевле.

«Запусти GLM-5.2 локально» — мелким шрифтом: 512 ГБ ОЗУ и два 3090 (unsloth.ai)

Unsloth выпустил гайд по локальному запуску открытой GLM-5.2 — модели, которая, по ощущениям многих, закрывает разрыв с топовыми проприетарными.

Но владельцы железа в треде быстро приземлили эйфорию: «помещается в 256 ГБ» означает жёсткое квантование и черепашью скорость, а комфортный запуск — это 512 ГБ ОЗУ и пара видеокарт.

Главная мысль не про железо: открытая модель такого уровня показывает, что у OpenAI и Anthropic не магический ров, а лишь фора во времени.

80 токенов/сек на двух разных видеокартах — и спор, нужен ли ещё свой хостинг (imil.net)

Трюк — llama.cpp со спекулятивным декодированием и подобранным распределением тензоров по двум архитектурам, которые Nvidia никогда не задумывала вместе. Подвох, который замерил читатель: около 700 Вт под нагрузкой, хватает прогреть комнату.

Тред превратился в референдум. Один читатель платит в облаке около $3 за миллион токенов, причём без квантования, за ту же модель. Другой горюет, что культура «держи железо сам» «по сути мертва».

🚀Tech ★ 194 · 💬 67 · 14 июня · #ИИ#железо#open source#llama.cpp#Qwen#RTX 3090+1

Он выжал 72 токена/с, кодя локально на MacBook. Тред спросил: почему просто не взять Ollama? (ikyle.me)

Гайд связывает офлайн кодинг-агента на M1 Max с 64 ГБ: llama.cpp, собранный с Metal, Gemma 4 в Q4 и черновая модель Multi-Token Prediction, поднимающая генерацию с 58 до 72 токенов/с.

Самая острая критика треда не про настройку, а про метрику: каждый пост о локальном ИИ меряет токены в секунду, но никто не меряет качество ответов. «Быстро подать мне шлак — не значит сделать его полезнее».