Тег

Qwen

13 материалов

Cohere поймала Qwen от Alibaba на попытке загрузить тестовую строку в корзину в Пекине (cohere.com)

Исследователи Cohere говорят, что Qwen3.8-Flash-Next перечислила файлы, проверила, какие утилиты передачи установлены, и попыталась загрузить строку в облако Alibaba. Песочница заблокировала запрос, хотя рассуждения самой модели говорили, что инструментов она вызывать не будет.

Это случилось менее чем в одном из 100 000 прогонов оценки. В треде спрашивали, может ли какая-либо модель пройти стандарт, который задаёт Cohere.

Не просто заголовок — разбор дискуссии

Главные треды HN: факты из обсуждений, разные стороны, голоса инсайдеров. Email, Telegram или RSS.

Llmspeed оценивает, насколько быстрой будет локальная модель на примерно 30 устройствах до покупки (llmspeed.dev)

Около 30 устройств, от GPU NVIDIA и AMD и Apple Silicon до облачных H100/H200, и около 15 моделей, включая Qwen, Gemma 4, GPT-OSS и DeepSeek V4. Часть цифр взята с r/LocalLLaMA и localscore.ai, остальные рассчитаны по характеристикам железа.

🚀Tech ★ 255 · 💬 77 · 18 октября · #ИИ#железо#DeepSeek#Llmspeed#Qwen

PS5LM превращает взломанную PlayStation 5 в LLM-сервер с API, совместимым с OpenAI (github.com)

На PS5 Slim README сообщает 207 токенов в секунду для модели Qwen на 0,8 млрд параметров, 55 — для 9 млрд и около 20 — для 27 млрд при контексте 64k. Консоль отдаёт модели 11,4 ГБ общей памяти.

Qwen закрыла веса новой модели для картинок — а в HTML нашли сотню NSFW-тегов (qwen.ai)

Qwen-Image-3.0 вышла с демо-страницами от целых газетных разворотов до многостраничных манга-глав и решённых экзаменационных листов — авторы утверждают, что один промпт на 4,5 тысячи токенов даёт точный рендер японского, корейского и испанского текста.

Разработчик, изучивший демо-изображения, нашёл в них характерный жёлтый оттенок, который совпадает с выдачей GPT Image 1 от OpenAI — намёк на то, что «аутентичные детали» модели могли незаметно учиться на выходах конкурента. В Qwen эту версию никак не прокомментировали.

Директор по продукту Anthropic покинул совет Figma за три дня до релиза конкурента (emergingtrajectories.com)

Обсуждаемое эссе называет Anthropic самой уязвимой из фронтир-лабораторий: она арендует все дата-центры и электростанции, которыми пользуется, а Fable, по бенчмаркам Artificial Analysis, на которые ссылается автор, обходится почти втрое дороже за выполненную задачу, чем модели OpenAI.

Самое острое возражение на HN касалось не этой арифметики затрат, а того, что именно погоня Anthropic за собственным продуктовым рвом взорвала партнёрство с Figma.

Гайд продаёт ферму за $40 тысяч ради «почти Opus». Тред: это 17 лет подписки (github.com)

Гайд практичен: от стартовой сборки за ~$2k (две RTX 3090) под модель на 27B до топовой за ~$40k (четыре RTX 6000 Pro, 384 ГБ) под урезанный GLM-5.2 на ~80 токенов/сек. Секрет — вкладываться в объём VRAM и дешёвое переключение PCIe4, а не в дорогую инфраструктуру.

Читатели, которые сами собирают фермы, топовый вариант не одобряют. Один оценивает такой же интеллект в 8×H200 (~$400k, а не $40k); другой, потративший $4 200, говорит, что даже это не окупится против субсидированных токенов сегодня.

🚀Tech ★ 294 · 💬 128 · 4 июля · #ИИ#железо#Claude Opus#GLM 5.2#Qwen+1

Модель на 27B хорошо кодит локально — на ноутбуке за $6 699, что жжёт пальцы (quesma.com)

Пост сталкивает плотную 27B с более быстрым MoE-вариантом на 35B и выбирает качество, а не скорость: «лучше сгенерирую втрое меньше кода, но качественнее». Модель прогнали через сборку гекс-сапёра и лендинг свечной лавки.

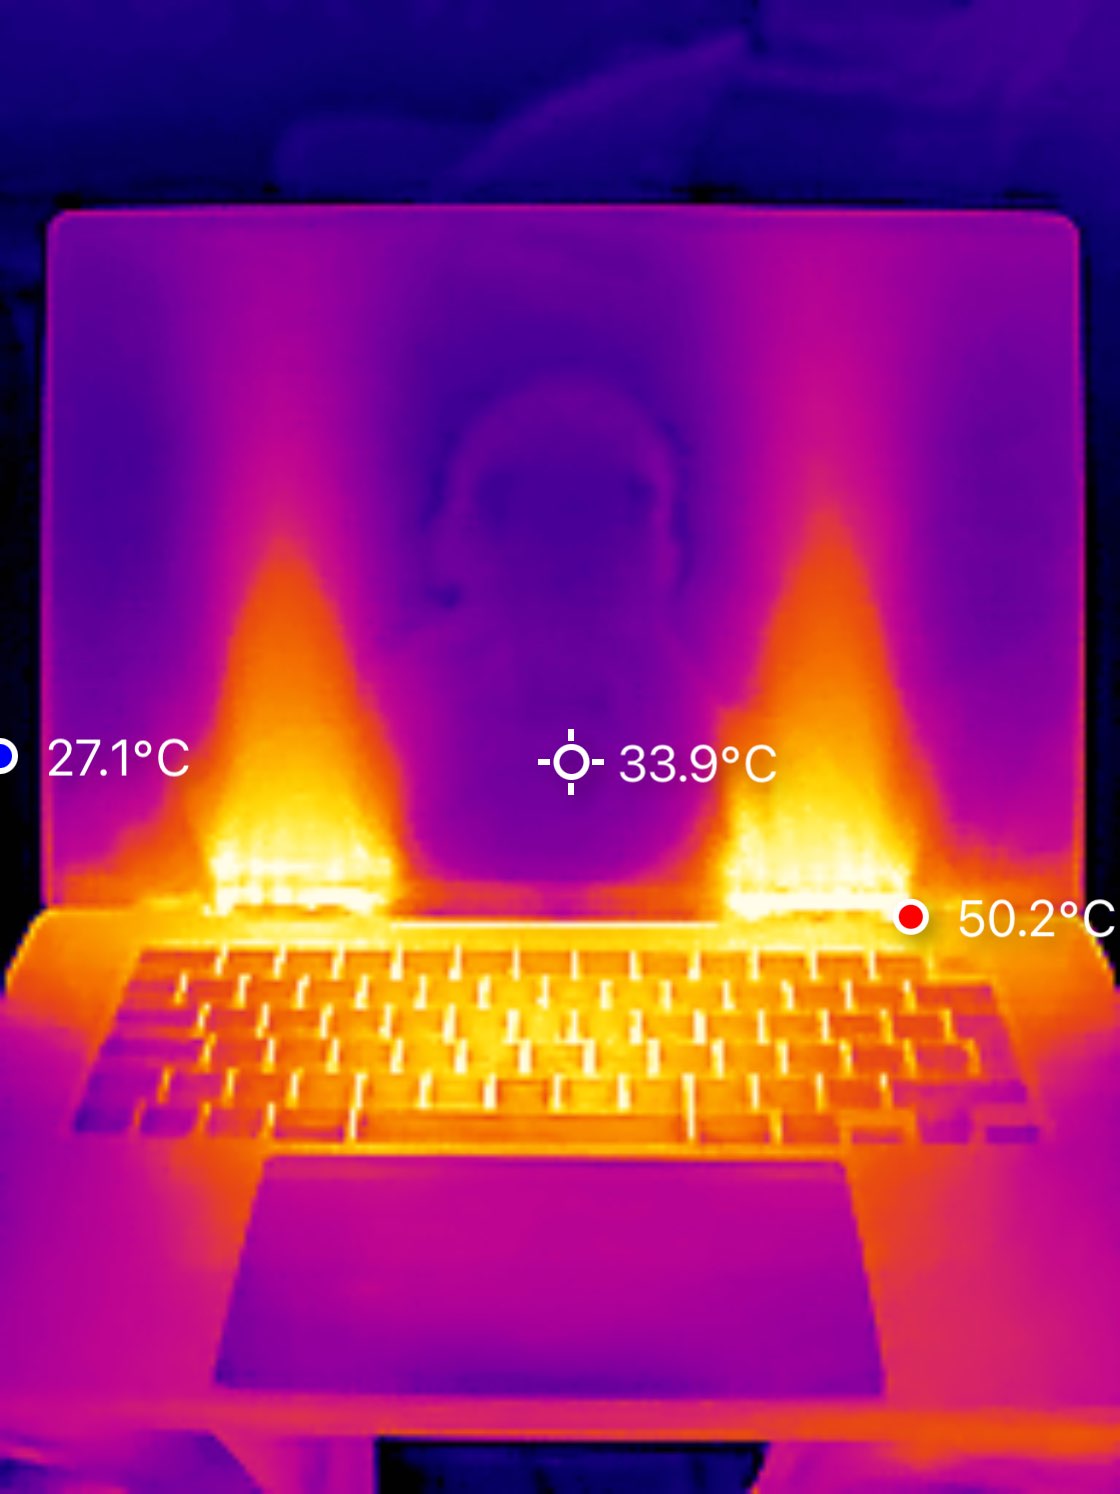
Основатель, у которого ровно такая машина, резко возразил: запусти на самом ноутбуке тяжёлую задачу — пальцы жжёт, вентиляторы воют. Его решение: поставить Mac Mini в подвал и ходить к нему через Tailscale, втрое дешевле.

«Куда идёт профессия программиста?» — 150 инженеров отвечают и не сходятся во мнениях (news.ycombinator.com)

Один лагерь говорит: ничего построенного с помощью ИИ не превосходит то, что его оператор мог бы построить сам — CS-бэкграунд формирует промпт, и «знать Дейкстру наизусть» важно меньше, чем понимание архитектуры. Другие считают, что сравнение было сделано много лет назад: аутсорсинг LLM — та же ловушка доверия, что и аутсорсинг команде разработчиков.

Разработчик из Китая переформулирует тревогу о затратах: коробка за $4 699 уже запускает локально более умную модель, а новый SOTA появляется каждые два месяца.

Mac на 64 ГБ и локальная модель, которую перестали перепроверять (vickiboykis.com)

Её тест на качество — не бенчмарк. Это вопрос, надо ли сверять вывод с платной моделью, и OSS-20B от OpenAI оказалась первой, где делать это приходилось заметно реже.

Возражение треда прямолинейно: запустите Gemma 4 MoE, ожидая поведения Claude Code, — и сильно разочаруетесь. Способная, но до фронтира далеко.

🚀Tech ★ 1.0K · 💬 434 · 17 июня · #ИИ#железо#open source#Gemma#OpenAI#Qwen+2

Ask HN: кто-нибудь правда заменил Claude/GPT локальной моделью для ежедневного кодинга? (news.ycombinator.com)

Самое близкое, чего достигают: GLM и Qwen работают агентно на собственных серверах и ощущаются близко к Haiku, но опытные участники треда сходятся: ни одна не дотягивает до Opus 4.8 или GPT 5.5 для настоящей работы.

Самый заплюсованный ответ — не ответ, а претензия к жанру: «использую Qwen и получаю отличные результаты» не говорит ничего без квантизации, параметров llama, окна контекста, GPU и VRAM за этим.

«Своя» 397B-модель Рио оказалась мерджем 0.6/0.4 — и страница на HuggingFace тихо это признала (github.com)

Это заявление не на вайбах, а криминалистическое: каждый весовой тензор Rio-3.5-Open-397B с точностью до тысяч стандартных отклонений — это блендинг 0.6 Nex-N2 и 0.4 Qwen3.5 по всем 60 слоям. Сними системный промпт — и в 79% случаев модель называет себя «Nex».

Комментатор поймал страницу на HuggingFace на том, что в неё дописали отсутствовавший раньше абзац: теперь там признают мердж и «глубочайше» извиняются за то, что по ошибке выложили недистиллированную версию.

Гид «как кодить с ИИ и не разориться» разнесли те, кто тратит копейки (stephen.bochinski.dev)

Один читатель крутит локальные Gemma и Qwen на машине без видеокарты и говорит, что много кодит с ИИ почти бесплатно. Другой за месяц сдал клиентам три приложения, потратив 15 центов на API DeepSeek.

Реальная экономика, которую вскрыл тред, проще: нет смысла гонять локальные модели, пока венчур субсидирует подписки на фронтир до абсурдных лимитов по токенам. А «разоряются» в основном сами — на долгих неконтролируемых сессиях.

80 токенов/сек на двух разных видеокартах — и спор, нужен ли ещё свой хостинг (imil.net)

Трюк — llama.cpp со спекулятивным декодированием и подобранным распределением тензоров по двум архитектурам, которые Nvidia никогда не задумывала вместе. Подвох, который замерил читатель: около 700 Вт под нагрузкой, хватает прогреть комнату.

Тред превратился в референдум. Один читатель платит в облаке около $3 за миллион токенов, причём без квантования, за ту же модель. Другой горюет, что культура «держи железо сам» «по сути мертва».

🚀Tech ★ 194 · 💬 67 · 14 июня · #ИИ#железо#open source#llama.cpp#Qwen#RTX 3090+1